Fundamentos de diseño de sistemas para desarrolladores
Los conceptos clave del diseño de sistemas escalables: balanceo de carga, caché, escalado de bases de datos, colas y las disyuntivas de arquitectura.
Por qué todo desarrollador necesita conocimientos de diseño de sistemas
No hace falta ser arquitecto de software para beneficiarte de pensar en términos de diseño de sistemas. Entender cómo encajan las piezas te convierte en un mejor desarrollador en todos los niveles: cambia cómo escribes código, cómo depuras problemas en producción y cómo evalúas las disyuntivas en las decisiones del día a día.
Concepto 1: escalado horizontal frente a vertical
Escalado vertical — hacer la máquina más grande (más CPU, más RAM). Es simple, pero tiene un techo y es un punto único de fallo.
Escalado horizontal — añadir más máquinas. Requiere que la aplicación sea sin estado (stateless).
Vertical:        Horizontal:
    [Big Server]     [Server] [Server] [Server]
         |               |       |       |
      [DB]           [Load Balancer]
                           |
                         [DB]
La idea clave: las aplicaciones sin estado (donde no se guardan datos de usuario en la memoria de la aplicación) pueden escalar horizontalmente. Si tu servidor guarda los datos de sesión en memoria, no puedes enrutar al mismo usuario hacia servidores distintos.
Solución: externalizar el estado.
// ❌ In-memory session — breaks horizontal scaling
const sessions = new Map<string, Session>();
app.use((req, res, next) => {
  req.session = sessions.get(req.cookies.sessionId);
  next();
});

// ✅ Externalized session — any server can serve any user
import { createClient } from "redis";
const redis = createClient({ url: process.env.REDIS_URL });

app.use(
  session({
    store: new RedisStore({ client: redis }),
    secret: process.env.SESSION_SECRET,
  }),
);
Concepto 2: capas de caché
El caché es la optimización de rendimiento con mayor impacto disponible a nivel de sistema. Hay cuatro lugares donde se puede cachear:
Browser Cache → CDN → Application Cache (Redis) → Database Query Cache
     ↑              ↑              ↑                        ↑
  Static assets  Static + API   Computed results      Query results
  ms access      ~10ms           ~1ms                  ~5ms
La parte más difícil no es implementar un caché, sino invalidarlo.
// Cache-aside pattern — the most common approach
async function getProduct(id: string): Promise<Product> {
  const cacheKey = `product:${id}`;

  // 1. Try cache
  const cached = await redis.get(cacheKey);
  if (cached) return JSON.parse(cached);

  // 2. Cache miss — fetch from database
  const product = await db.product.findUnique({ where: { id } });
  if (!product) throw new NotFoundError();

  // 3. Populate cache with TTL
  await redis.setEx(cacheKey, 3600, JSON.stringify(product)); // 1 hour TTL

  return product;
}

// Invalidate on mutation
async function updateProduct(id: string, data: Partial<Product>) {
  const product = await db.product.update({ where: { id }, data });
  await redis.del(`product:${id}`); // Invalidate cache entry
  return product;
}
Estampida de caché: cuando el caché expira, todas las solicitudes fallan al mismo tiempo y golpean la base de datos de golpe. Se mitiga con expiración temprana probabilística o con bloqueos distribuidos.
Concepto 3: colas de mensajes
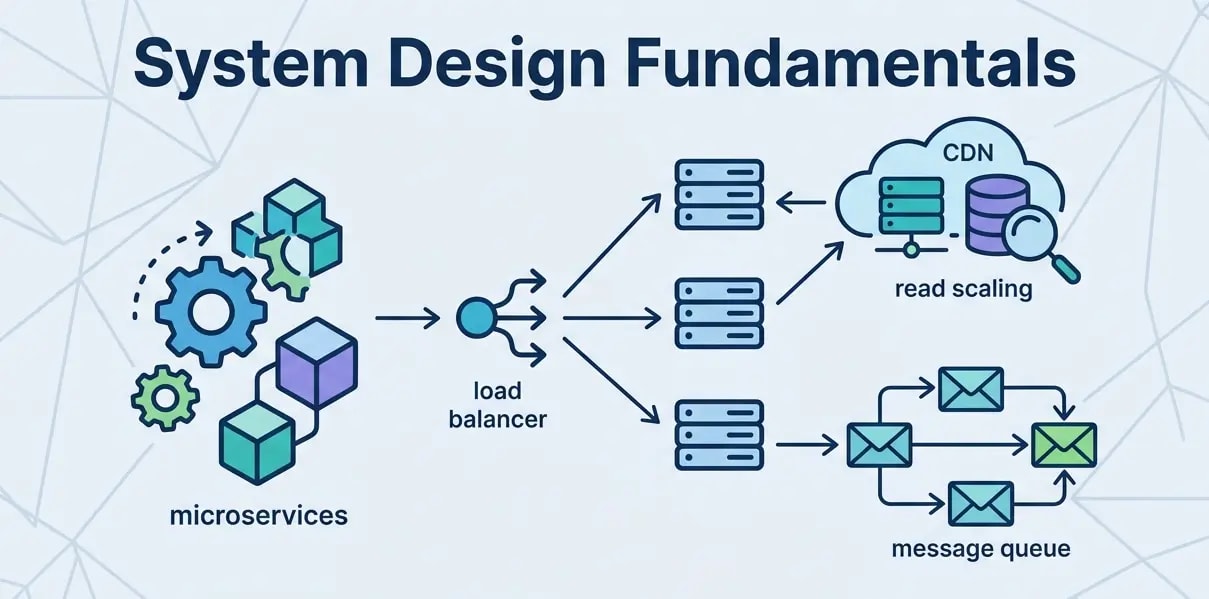
Las colas desacoplan a los productores de los consumidores, lo que permite:
- Procesamiento asíncrono — devolver una respuesta de inmediato y procesar en segundo plano
- Nivelación de carga — absorber picos de tráfico sin saturar los servicios posteriores
- Lógica de reintentos — los trabajos fallidos pueden reintentarse automáticamente
// Without a queue — user waits for email to send
app.post("/api/register", async (req, res) => {
  const user = await createUser(req.body);
  await sendWelcomeEmail(user.email); // Slow — blocks response
  res.json({ user });
});

// With a queue — response is immediate, email is async
app.post("/api/register", async (req, res) => {
  const user = await createUser(req.body);
  await queue.add("send-welcome-email", { userId: user.id }); // Fast — non-blocking
  res.json({ user });
});

// Worker processes jobs independently
queue.process("send-welcome-email", async (job) => {
  const user = await db.user.findUnique({ where: { id: job.data.userId } });
  await emailService.sendWelcome(user);
});
Concepto 4: escalado de bases de datos
Cuando una única base de datos no puede con la carga:
Réplicas de lectura — replican las escrituras hacia réplicas de solo lectura. Las consultas con mucha lectura se enrutan hacia las réplicas.
// Primary for writes, replica for reads
const writeDb = new PrismaClient({ datasources: { db: { url: PRIMARY_URL } } });
const readDb = new PrismaClient({ datasources: { db: { url: REPLICA_URL } } });

async function getUserDashboard(userId: string) {
  // Read from replica — ok if slightly stale
  return readDb.user.findUnique({
    where: { id: userId },
    include: { recentOrders: { take: 10 } },
  });
}

async function updateUserProfile(userId: string, data: Partial<User>) {
  // Write to primary — must be consistent
  return writeDb.user.update({ where: { id: userId }, data });
}
Particionado (sharding) — divide los datos entre varias bases de datos según una clave de partición (por ejemplo, rangos de ID de usuario). Añade una complejidad operativa considerable, así que conviene recurrir primero a las réplicas de lectura.
Concepto 5: el teorema CAP en la práctica
En un sistema distribuido, solo puedes garantizar dos de las tres propiedades:
- Consistencia — cada lectura devuelve la escritura más reciente
- Disponibilidad — cada solicitud recibe una respuesta
- Tolerancia a particiones — el sistema sigue funcionando pese a fallos de red
Los fallos de red ocurren. Durante una partición, tienes que elegir entre consistencia y disponibilidad.
La mayoría de las aplicaciones web deberían optar por disponibilidad + consistencia eventual:
// Eventual consistency — show cached data, sync in background
async function getInventoryCount(productId: string) {
  // Return cached count — may be slightly stale
  const cached = await redis.get(`inventory:${productId}`);
  if (cached) return parseInt(cached);

  // Fallback to database
  const product = await db.product.findUnique({
    where: { id: productId },
    select: { inventoryCount: true },
  });
  await redis.setEx(
    `inventory:${productId}`,
    30,
    String(product.inventoryCount),
  );
  return product.inventoryCount;
}
Las transacciones bancarias y los historiales médicos necesitan consistencia estricta. El conteo de inventario de productos puede tolerar un retraso de 30 segundos.
El modelo mental
El diseño de sistemas consiste en entender dónde están los cuellos de botella y qué disyuntivas son aceptables para tu caso de uso.
Preguntas que hacerte para cualquier sistema:
- ¿Cuál es la proporción entre lecturas y escrituras?
- ¿Cuál es la latencia aceptable?
- ¿Qué ocurre si falla algún componente?
- ¿Cómo es el patrón de acceso a los datos?
- ¿Cuáles son los requisitos de consistencia?
Empieza simple. Añade complejidad solo cuando tengas evidencia de que la solución simple se ha convertido en un cuello de botella. La optimización prematura en el diseño de sistemas — sobrediseñar para una escala que todavía no tienes — es tan peligrosa como escribir microoptimizaciones prematuras en el código.