Kubernetes Pods und Deployments: Eine praktische Einführung
Ein praxisnaher Leitfaden zu Kubernetes Pods, Deployments und Services, der die wichtigsten Grundkonzepte für den Betrieb von Produktions-Workloads behandelt.
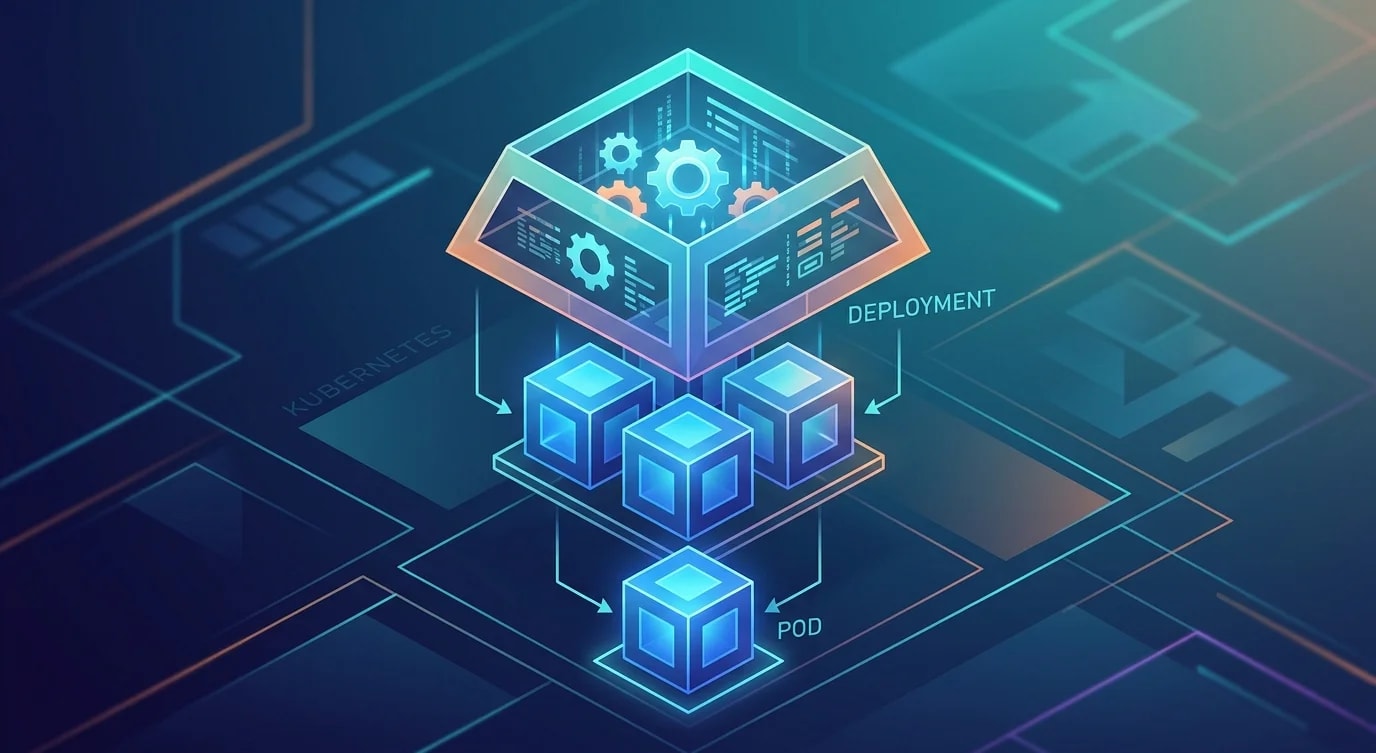
Die Kubernetes-Dokumentation ist riesig. Die API-Oberfläche ist enorm. Neue Entwicklerinnen und Entwickler starren auf eine Wand aus YAML und wissen nicht, wo sie anfangen sollen. Die Antwort sind drei Grundbausteine: Pods, Deployments und Services. Diese drei Abstraktionen decken 90 % dessen ab, was man braucht, um eine Webanwendung in Produktion zu betreiben.
Dieser Leitfaden erklärt, was jeder dieser Bausteine tut, wie sie zusammenspielen und welche Konfigurationen bei echten Workloads wirklich zählen.
Pods: die kleinste Einheit
Ein Pod besteht aus einem oder mehreren Containern, die gemeinsam auf demselben Node laufen und sich Netzwerk und Speicher teilen. Die meisten Pods enthalten nur einen einzigen Container. Das Multi-Container-Muster ist für Sidecars gedacht: einen Logging-Agenten, einen Proxy oder einen Init-Container, der vor dem eigentlichen Hauptprozess Einrichtungsschritte ausführt.
# A minimal Pod definition — rarely used directly in production
apiVersion: v1
kind: Pod
metadata:
  name: api-server
  labels:
    app: api
    version: v1
spec:
  containers:
    - name: api
      image: myregistry/api-server:1.4.2
      ports:
        - containerPort: 3000
      env:
        - name: NODE_ENV
          value: "production"
        - name: DATABASE_URL
          valueFrom:
            secretKeyRef:
              name: db-credentials
              key: url
      resources:
        requests:
          memory: "128Mi"
          cpu: "100m"
        limits:
          memory: "256Mi"
          cpu: "500m"
Man erstellt Pods so gut wie nie direkt. Stirbt ein Pod, startet ihn nichts neu. Deployments verwalten den Lebenszyklus der Pods – deshalb sind sie die eigentliche Arbeitseinheit in Produktionsumgebungen.
Deployments: den Lebenszyklus von Pods verwalten
Ein Deployment beschreibt den gewünschten Zustand: welches Container-Image verwendet wird, wie viele Replicas laufen sollen und wie Updates ausgerollt werden. Der Deployment-Controller gleicht die tatsächliche Situation fortlaufend mit diesem gewünschten Zustand ab.
# ❌ Running pods directly — no restart, no scaling, no rollback
apiVersion: v1
kind: Pod
metadata:
  name: api-server-1
spec:
  containers:
    - name: api
      image: myregistry/api-server:1.4.2
---
apiVersion: v1
kind: Pod
metadata:
  name: api-server-2
spec:
  containers:
    - name: api
image: myregistry/api-server:1.4.2# ✅ A Deployment manages pods with automatic restart, scaling, and rollback
apiVersion: apps/v1
kind: Deployment
metadata:
name: api-server
labels:
app: api
spec:
replicas: 3
selector:
matchLabels:
app: api
strategy:
type: RollingUpdate
rollingUpdate:
maxSurge: 1
maxUnavailable: 0
template:
metadata:
labels:
app: api
version: v1
spec:
containers:
- name: api
image: myregistry/api-server:1.4.2
ports:
- containerPort: 3000
resources:
requests:
memory: "128Mi"
cpu: "100m"
limits:
memory: "256Mi"
cpu: "500m"
readinessProbe:
httpGet:
path: /health
port: 3000
initialDelaySeconds: 5
periodSeconds: 10
livenessProbe:
httpGet:
path: /health
port: 3000
initialDelaySeconds: 15
periodSeconds: 20Die wichtigsten Felder in diesem Deployment:
- replicas: 3: drei Instanzen des Pods ausführen
- maxSurge: 1: erlaubt während Updates einen zusätzlichen Pod über der gewünschten Anzahl
- maxUnavailable: 0: die Anzahl der verfügbaren Replicas darf während Updates nie unter den Sollwert fallen
- readinessProbe: teilt Kubernetes mit, wann der Pod Traffic annehmen kann
- livenessProbe: teilt Kubernetes mit, wann der Pod feststeckt und neu gestartet werden muss
Rolling Updates und Rollbacks
Deployments führen Updates aus, indem sie alte Pods schrittweise durch neue ersetzen. Die Einstellungen maxSurge und maxUnavailable steuern dabei Geschwindigkeit und Verfügbarkeit während des Updates.
# Update the image — triggers a rolling update
kubectl set image deployment/api-server \
  api=myregistry/api-server:1.5.0

# Watch the rollout progress
kubectl rollout status deployment/api-server

# Check rollout history
kubectl rollout history deployment/api-server

# Rollback to the previous version
kubectl rollout undo deployment/api-server

# Rollback to a specific revision
kubectl rollout undo deployment/api-server --to-revision=3
Der Rolling-Update-Prozess mit maxSurge: 1, maxUnavailable: 0 und 3 Replicas läuft so ab:
Step 1: [v1] [v1] [v1] [v2]     ← new Pod created (4 total)
Step 2: [v1] [v1] [v2] [v2]     ← old Pod removed, new created
Step 3: [v1] [v2] [v2] [v2]     ← continuing replacement
Step 4: [v2] [v2] [v2]          ← rollout complete (3 total)
Traffic wird nur an Pods weitergeleitet, die die Readiness-Probe bestehen – so landen Nutzerinnen und Nutzer nie bei einem Pod, der noch startet.
Services: Pods nach außen freigeben
Pods erhalten flüchtige IP-Adressen, die sich bei jedem Neustart ändern. Ein Service bietet eine stabile Netzwerkidentität: einen festen DNS-Namen und eine feste IP, die Traffic an gesunde Pods weiterleiten, die einem Label-Selector entsprechen.
# ClusterIP Service — internal access only
apiVersion: v1
kind: Service
metadata:
  name: api-service
spec:
  type: ClusterIP
  selector:
    app: api
  ports:
    - protocol: TCP
      port: 80
      targetPort: 3000
---
# Other pods can now reach the API at http://api-service:80
# Kubernetes DNS resolves api-service to the ClusterIP# LoadBalancer Service — external access via cloud load balancer
apiVersion: v1
kind: Service
metadata:
name: api-external
spec:
type: LoadBalancer
selector:
app: api
ports:
- protocol: TCP
port: 443
targetPort: 3000Die verschiedenen Service-Typen erfüllen unterschiedliche Zwecke:
- ClusterIP: nur intern erreichbar. Für die Kommunikation zwischen Microservices.
- NodePort: macht den Service auf der IP jedes Nodes über einen festen Port erreichbar. Nützlich für die Entwicklung.
- LoadBalancer: stellt einen Load Balancer in der Cloud bereit. Der Standard für öffentlich erreichbare Services.
Requests und Limits für Ressourcen
Ohne Ressourcenkonfiguration kann ein einzelner Pod sämtliche Ressourcen eines Nodes beanspruchen und anderen Workloads die Grundlage entziehen. Requests garantieren eine Mindestzuteilung. Limits begrenzen das Maximum.
resources:
  # Requests: minimum guaranteed resources
  # Used by scheduler to place pods on nodes
  requests:
    memory: "128Mi"
    cpu: "100m"    # 100 millicores = 0.1 CPU cores

  # Limits: maximum allowed resources
  # Pod is killed (OOMKill) if it exceeds memory limit
  # Pod is throttled if it exceeds CPU limit
  limits:
    memory: "256Mi"
cpu: "500m" # 500 millicores = 0.5 CPU cores# Check actual resource usage vs. requests/limits
kubectl top pods -n default
# Example output:
# NAME CPU(cores) MEMORY(bytes)
# api-server-7d5f8b6c4-abc12 45m 98Mi
# api-server-7d5f8b6c4-def34 52m 102Mi
# api-server-7d5f8b6c4-ghi56 38m 95MiZu hoch angesetzte Requests verschwenden Cluster-Ressourcen. Zu niedrig angesetzte Requests führen zu Scheduling-Fehlern, sobald Nodes voll erscheinen. Beginne mit Requests auf Basis des beobachteten Verbrauchs (aus kubectl top) und setze Limits auf das Doppelte des Requests.
Health Checks, die wirklich funktionieren
Readiness- und Liveness-Probes gehören zu den am häufigsten falsch konfigurierten Einstellungen. Eine schlechte Probe-Konfiguration führt zu Kaskadenausfällen.
# ❌ Common mistake: same endpoint, same timing for both probes
readinessProbe:
  httpGet:
    path: /health
    port: 3000
  initialDelaySeconds: 5
  periodSeconds: 5
livenessProbe:
  httpGet:
    path: /health
    port: 3000
  initialDelaySeconds: 5
periodSeconds: 5# ✅ Different timing, different thresholds
readinessProbe:
httpGet:
path: /health/ready
port: 3000
initialDelaySeconds: 5
periodSeconds: 10
failureThreshold: 3
# Pod removed from Service after 3 consecutive failures (30s)
livenessProbe:
httpGet:
path: /health/live
port: 3000
initialDelaySeconds: 30
periodSeconds: 20
failureThreshold: 5
# Pod restarted after 5 consecutive failures (100s)
startupProbe:
httpGet:
path: /health/live
port: 3000
failureThreshold: 30
periodSeconds: 10
# Allows up to 300s for slow-starting appsDie Liveness-Probe sollte einen längeren initialDelaySeconds-Wert und einen höheren failureThreshold haben als die Readiness-Probe. Eine zu aggressive Liveness-Probe startet Pods neu, die nur vorübergehend überlastet sind, und erzeugt so eine Neustartschleife, die einen Ausfall noch verschlimmert.
Der /health/ready-Endpunkt der Readiness-Probe sollte nachgelagerte Abhängigkeiten prüfen (Datenbankverbindung, Erreichbarkeit des Caches). Der /health/live-Endpunkt der Liveness-Probe sollte dagegen nur eine einfache Prüfung sein, ob "der Prozess noch lebt" – Abhängigkeitsprüfungen gehören niemals in Liveness-Probes.
ConfigMaps und Secrets
Konfiguration und Secrets sollten außerhalb des Container-Images liegen und als Kubernetes-Ressourcen verwaltet werden.
# ConfigMap for non-sensitive configuration
apiVersion: v1
kind: ConfigMap
metadata:
  name: api-config
data:
  LOG_LEVEL: "info"
  CACHE_TTL: "300"
  FEATURE_NEW_UI: "true"
---
# Secret for sensitive values (base64 encoded)
apiVersion: v1
kind: Secret
metadata:
  name: db-credentials
type: Opaque
data:
  url: cG9zdGdyZXM6Ly91c2VyOnBhc3NAZGIuZXhhbXBsZS5jb206NTQzMi9teWRi
password: c3VwZXJzZWNyZXQ=# Reference in Deployment
spec:
containers:
- name: api
image: myregistry/api-server:1.4.2
envFrom:
- configMapRef:
name: api-config
env:
- name: DATABASE_URL
valueFrom:
secretKeyRef:
name: db-credentials
key: urlMit ConfigMaps lässt sich die Konfiguration ändern, ohne die Container-Images neu zu bauen. Eine ConfigMap zu ändern und die Pods neu zu starten, setzt eine Konfigurationsänderung innerhalb von Sekunden um.
Die wichtigsten Erkenntnisse
- Niemals nackte Pods betreiben: für automatischen Neustart und Rollout-Management immer Deployments verwenden
- Resource Requests anhand des beobachteten Verbrauchs festlegen:
kubectl topliefert echte Zahlen statt Schätzungen - Readiness- und Liveness-Probes trennen: unterschiedliche Endpunkte, unterschiedliche Schwellenwerte, unterschiedliche Zwecke
- Rolling Updates mit maxUnavailable: 0 verwenden: während Deploys die volle Kapazität aufrechterhalten
- Mit ClusterIP-Services beginnen: nur das extern freigeben, was wirklich externen Zugriff braucht
- Geheimnisse in Secrets und Konfiguration in ConfigMaps aufbewahren: niemals umgebungsspezifische Werte fest in Images einbacken