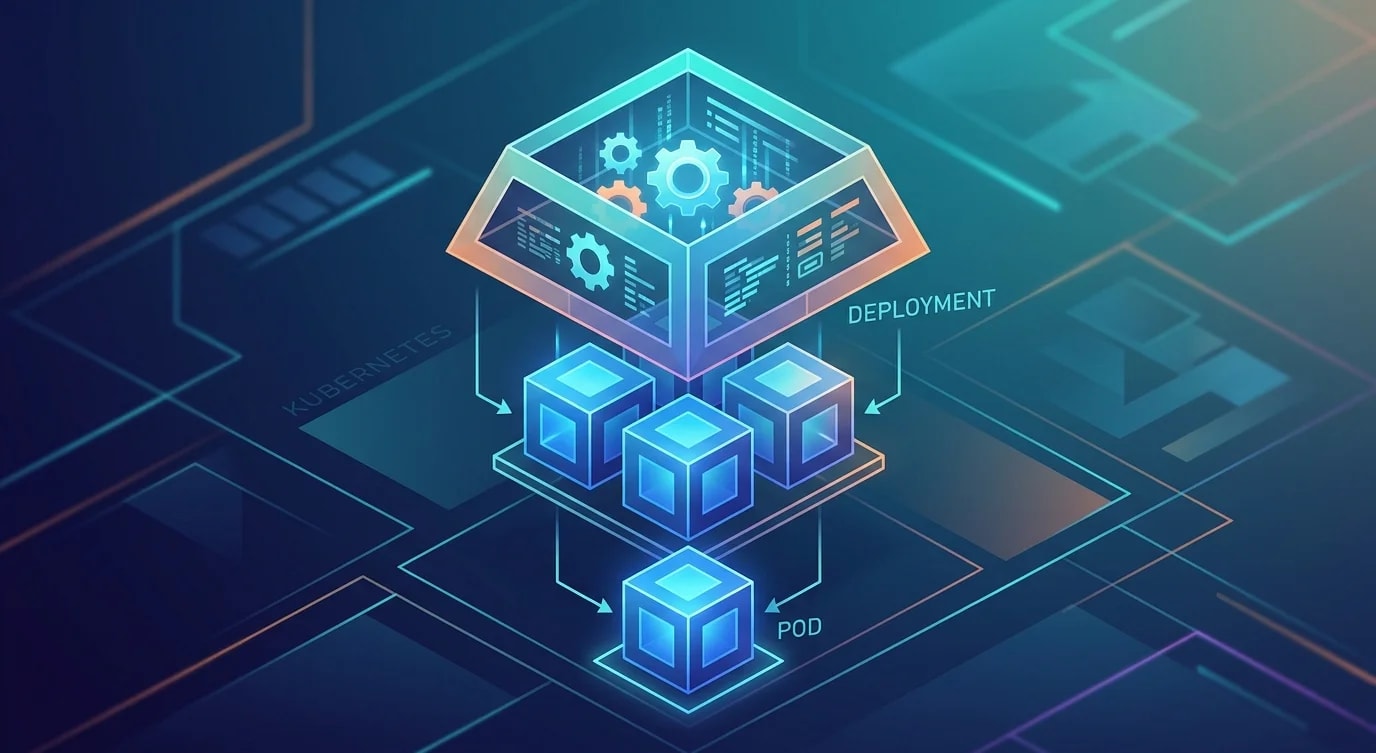
Grundlagen der Container-Orchestrierung: Von Docker zu Kubernetes
Einen Container zu starten ist einfach; Hunderte zu orchestrieren braucht Scheduling, Netzwerk, Service-Discovery und Selbstheilung — genau das ist Kubernetes.
Einen Container auf einer einzelnen Maschine mit docker run zu starten, ist unkompliziert. Produktionsworkloads erfordern jedoch mehrere Instanzen auf mehreren Hosts, automatische Neustarts bei Fehlern, Rolling Deployments ohne Ausfallzeit und Service-zu-Service-Kommunikation. Container-Orchestrierungsplattformen lösen diese Probleme. Kubernetes hat sich zum Industriestandard entwickelt, aber zu verstehen, was es tatsächlich tut — und warum — ist wichtiger als YAML auswendig zu lernen.
Die Probleme, die Orchestrierung löst
Ohne Orchestrierung loggst du dich manuell per SSH auf Servern ein, ziehst Images, startest Container, konfigurierst das Netzwerk und überwachst den Zustand. Wenn ein Container abstürzt, startest du ihn neu. Wenn der Traffic steigt, fügst du Container hinzu. Beim Deployment stoppst du die alte Version und startest die neue — mit Ausfallzeit.
Orchestrierung automatisiert all das:
# A simple Kubernetes Deployment — declares desired state
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api-server
spec:
  replicas: 3  # Always keep 3 instances running
  selector:
    matchLabels:
      app: api-server
  template:
    metadata:
      labels:
        app: api-server
    spec:
      containers:
        - name: api
          image: registry.example.com/api-server:v1.2.0
          ports:
            - containerPort: 3000
          resources:
            requests:
              memory: "256Mi"
              cpu: "250m"
            limits:
              memory: "512Mi"
              cpu: "500m"
Du deklarierst "Ich möchte 3 Replikas dieses Containers", und Kubernetes stellt sicher, dass genau 3 auf den verfügbaren Nodes laufen. Fällt ein Node aus, verschiebt Kubernetes die Pods auf gesunde Nodes.
Kernkonzepte
Pods
Ein Pod ist die kleinste deploybare Einheit — ein oder mehrere Container, die sich Netzwerk und Speicher teilen. In der Praxis enthalten die meisten Pods einen einzigen Anwendungscontainer.
# Pod spec with liveness and readiness probes
spec:
  containers:
    - name: api
      image: registry.example.com/api-server:v1.2.0
      livenessProbe:
        httpGet:
          path: /health
          port: 3000
        initialDelaySeconds: 10
        periodSeconds: 15
      readinessProbe:
        httpGet:
          path: /ready
          port: 3000
        initialDelaySeconds: 5
        periodSeconds: 10
Die Liveness-Probe sagt Kubernetes, wann ein Container neu gestartet werden soll (er hängt oder ist blockiert). Die Readiness-Probe sagt Kubernetes, wann ein Container Traffic annehmen kann (Abhängigkeiten sind verbunden, der Warm-up ist abgeschlossen).
Services und Netzwerk
Pods erhalten flüchtige IP-Adressen, die sich bei jedem Neustart ändern. Ein Service bietet einen stabilen Netzwerk-Endpunkt, der Traffic an gesunde Pods weiterleitet.
# ❌ Hardcoding pod IPs — breaks on restart
# connection string: "http://10.0.4.23:3000"

# ✅ Using a Kubernetes Service — stable DNS name
apiVersion: v1
kind: Service
metadata:
  name: api-server
spec:
  selector:
    app: api-server  # Routes to pods with this label
  ports:
    - port: 80
      targetPort: 3000
  type: ClusterIP  # Internal only

# Other services connect via: http://api-server.default.svc.cluster.local
# Or simply: http://api-server (within the same namespace)
Rolling Deployments
Wenn du das Container-Image aktualisierst, führt Kubernetes standardmäßig ein Rolling Update durch — die alten Pods werden schrittweise durch neue ersetzt.
spec:
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxUnavailable: 1  # At most 1 pod down during update
      maxSurge: 1         # At most 1 extra pod during update
Die Rollout-Sequenz für 3 Replikas:
- 1 neuen Pod erstellen (v1.3.0) — jetzt 3 alte + 1 neuer
- Warten, bis der neue Pod die Readiness-Probe besteht
- 1 alten Pod beenden (v1.2.0) — jetzt 2 alte + 1 neuer
- Wiederholen, bis alle Pods v1.3.0 laufen
# Deploy a new version
kubectl set image deployment/api-server api=registry.example.com/api-server:v1.3.0

# Watch the rollout progress
kubectl rollout status deployment/api-server

# Something went wrong? Roll back instantly
kubectl rollout undo deployment/api-server
Konfigurationsverwaltung
Kubernetes trennt die Konfiguration von den Container-Images mithilfe von ConfigMaps und Secrets.
# ConfigMap for non-sensitive configuration
apiVersion: v1
kind: ConfigMap
metadata:
  name: api-config
data:
  LOG_LEVEL: "info"
  CACHE_TTL: "300"
  MAX_CONNECTIONS: "100"

---
# Secret for sensitive data (base64 encoded, ideally with external secrets manager)
apiVersion: v1
kind: Secret
metadata:
  name: api-secrets
type: Opaque
data:
  DATABASE_URL: cG9zdGdyZXM6Ly91c2VyOnBhc3NAaG9zdDo1NDMyL2Ri

---
# Reference in the Deployment
spec:
  containers:
    - name: api
      envFrom:
        - configMapRef:
            name: api-config
        - secretRef:
            name: api-secrets
Resource Requests und Limits
Ohne Ressourcenbeschränkungen kann ein fehlerhafter Container die gesamte CPU und den gesamten Speicher eines Nodes verbrauchen und alle anderen Workloads beeinträchtigen.
# ❌ No resource constraints — risky in multi-tenant clusters
spec:
  containers:
    - name: api
      image: registry.example.com/api-server:v1.2.0

# ✅ Define requests (scheduling guarantee) and limits (hard cap)
spec:
  containers:
    - name: api
      image: registry.example.com/api-server:v1.2.0
      resources:
        requests:
          memory: "256Mi"   # Guaranteed minimum
          cpu: "250m"        # 0.25 CPU cores
        limits:
          memory: "512Mi"   # OOM-killed if exceeded
          cpu: "500m"        # Throttled if exceeded
Requests bestimmen das Scheduling — der Scheduler platziert Pods auf Nodes mit ausreichend verfügbaren Ressourcen. Limits erzwingen harte Obergrenzen — das Überschreiten des Speicherlimits beendet den Container (OOM-Kill), das Überschreiten des CPU-Limits drosselt ihn.
Wann man Kubernetes einsetzen sollte
Kubernetes bringt erhebliche betriebliche Komplexität mit sich. Es lohnt sich, wenn du viele Services hast, die unabhängige Skalierung, automatisierte Rollouts und Selbstheilung benötigen. Für einen einzelnen Service mit geringer Komplexität ist eine einfachere Plattform wie Docker Compose, ECS oder sogar ein gemanagtes PaaS möglicherweise die bessere Wahl.
Die wichtigsten Erkenntnisse
- Orchestrierung automatisiert Deployment, Skalierung und Wiederherstellung — du deklarierst den gewünschten Zustand, die Plattform setzt ihn durch
- Pods sind die atomare Einheit — verwende Liveness-Probes für die Neustartlogik und Readiness-Probes für das Traffic-Routing
- Services bieten stabiles Networking — verlasse dich niemals direkt auf Pod-IPs
- Rolling Updates ermöglichen Deployments ohne Ausfallzeit — mit sofortiger Rollback-Fähigkeit
- Setze immer Resource Requests und Limits — verhindere Noisy-Neighbor-Probleme in gemeinsam genutzten Clustern
- Kubernetes ist eine Investition — prüfe vor der Einführung, ob deine betriebliche Komplexität das rechtfertigt