GraphQL Persisted Queries: Kleinere Payloads, kleinere Angriffsfläche
Wie Persisted Queries GraphQL-Payloads verkleinern, CDN-Caching ermöglichen und beliebigen Query-Missbrauch verhindern.
Jede GraphQL-Anfrage schickt bei jedem Aufruf das vollständige Query-Dokument über die Leitung — für immer. Ein Dashboard, das hundertmal pro Session dieselbe 40-Zeilen-Query abfeuert, sendet diese 40 Zeilen hundertmal. Schlimmer noch: Da der Client jede beliebige gültige Query senden kann, ist dein GraphQL-Endpunkt faktisch eine offene SQL-Konsole mit ein paar Extraschritten — es sei denn, du unternimmst etwas dagegen.
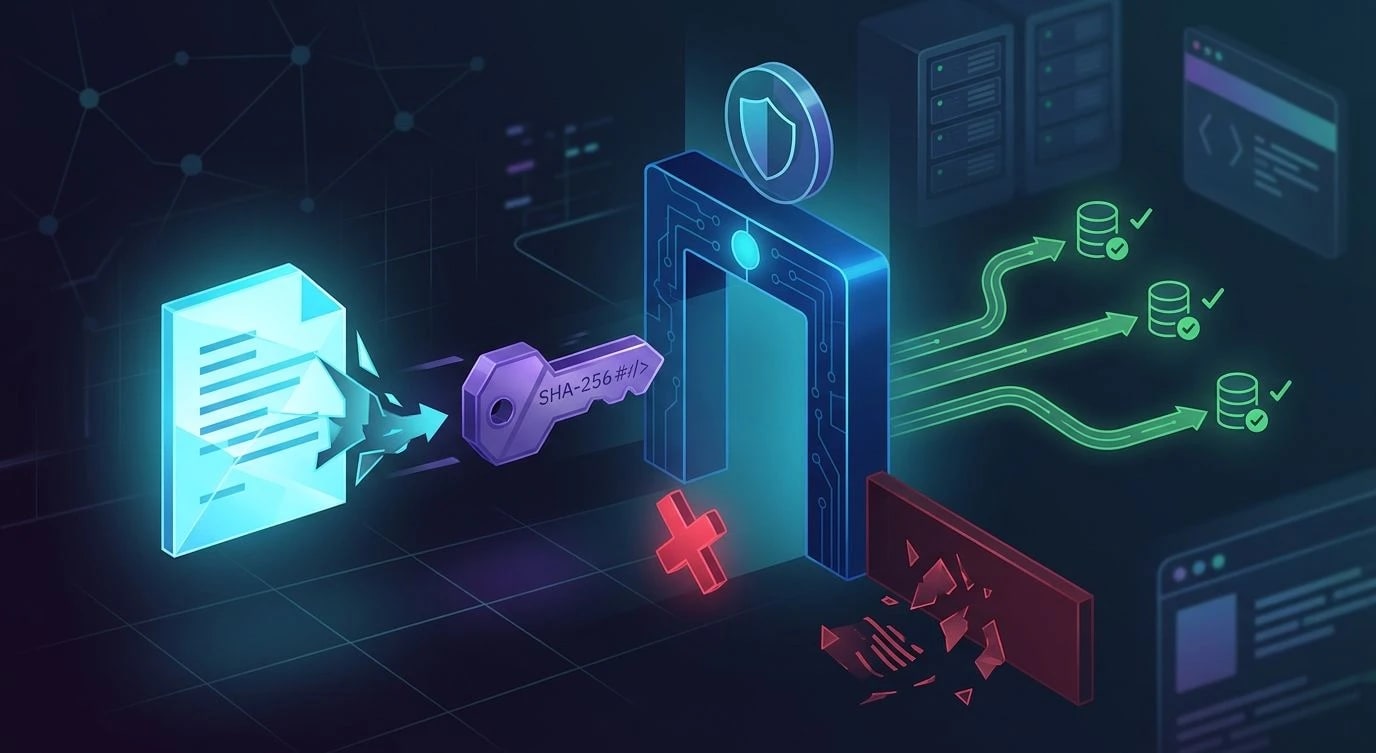
Persisted Queries lösen beide Probleme gleichzeitig. Der Client sendet einen kurzen Hash statt des Query-Texts, der Server löst den Hash zu einer bekannten Operation auf, und alles, was nicht auf der Allowlist steht, wird abgelehnt, bevor es überhaupt einen Resolver erreicht. Das ist eine dieser Änderungen, die wie eine Performance-Optimierung aussieht, in Wirklichkeit aber eine Sicherheitsgrenze im Gewand einer Performance-Optimierung ist.
Was eine Persisted Query wirklich ist
Eine Persisted Query ist eine GraphQL-Operation, die vorab registriert und über einen Hash (typischerweise SHA-256 des Query-Texts) identifiziert wird, statt über das rohe Dokument. Der Client sendet den Hash; der Server schlägt die zugehörige Query in einem Store nach, den er selbst kontrolliert.
# ❌ Was heute bei jeder einzelnen Anfrage über die Leitung geht
query GetDashboard($userId: ID!) {
  user(id: $userId) {
    id
    name
    recentOrders(limit: 10) {
      id
      total
      status
      items {
        sku
        quantity
      }
    }
  }
}// ✅ Was mit Persisted Queries über die Leitung geht
{
"id": "a13f9e2c8b7d4f0e1a9c8b7d4f0e1a9c",
"variables": { "userId": "usr_8821" }
}Der Hash ist deterministisch und wird aus dem Query-Text abgeleitet — zwei Clients, die dieselbe Operation registrieren, erzeugen also denselben Identifier. Apollos Automatic Persisted Queries (APQ) haben diesen Handshake formalisiert, und Relay bringt dieselbe Idee als Compiler-Feature erster Klasse mit, statt als Runtime-Fallback.
Automatic vs. Fully Persisted
Es gibt zwei Varianten, und sie lösen unterschiedliche Probleme.
| Ansatz | Registrierung | Sicherheitsgarantie |
|---|---|---|
| Automatic (APQ) | Lazy, bei erster Anfrage | Keine — jede Query kann sich weiterhin registrieren |
| Fully Persisted | Zur Build-Zeit, nur Allowlist | Stark — unbekannte Hashes werden abgelehnt |
APQ ist reine Bandbreiten-Optimierung: Der Client sendet zuerst einen Hash, und falls der Server ihn noch nicht kennt, schickt der Client einmalig die vollständige Query nach, damit der Server sie cachen kann. Danach läuft jeder weitere Aufruf nur noch über den Hash. Das ist ein guter erster Schritt und erfordert kaum Server-Änderungen, hindert einen Angreifer aber nicht daran, eine beliebige eigene Query zu registrieren — der Server cacht bereitwillig alles, was er bekommt.
Fully Persisted Queries schließen diese Lücke. Die Allowlist wird zur Build-Zeit aus deiner tatsächlichen Client-Codebasis erstellt, als festes Manifest an den Server ausgeliefert, und der Server lehnt alles ab, was nicht darin enthalten ist. Das ist die Variante, zu der man greifen sollte, wenn Introspection-Missbrauch oder Query-Complexity-Angriffe im Bedrohungsmodell vorkommen — zusammen mit Maßnahmen wie Query-Cost-Analyse zur Begrenzung von Tiefe und Komplexität.
Die Allowlist zur Build-Zeit aufbauen
Die meisten GraphQL-Build-Tools (Relay-Compiler, graphql-codegen, Apollos persisted-query-lists-Paket) können jede Operation aus deinem Client-Quellcode extrahieren und ein Manifest ausgeben, das nach Hash indiziert ist.
// scripts/build-persisted-queries.ts
import { createHash } from "node:crypto";
import { glob } from "glob";
import { readFile, writeFile } from "node:fs/promises";
import { parse, print } from "graphql";

interface PersistedQueryEntry {
  hash: string;
  query: string;
  operationName: string;
}

async function buildManifest(): Promise<void> {
  const files = await glob("src/**/*.graphql");
  const entries: PersistedQueryEntry[] = [];

  for (const file of files) {
    const raw = await readFile(file, "utf8");
    // Normalize whitespace so semantically identical
    // queries always hash to the same value.
    const normalized = print(parse(raw));
    const hash = createHash("sha256")
      .update(normalized)
      .digest("hex");

    const operationName =
      parse(raw).definitions[0]?.kind === "OperationDefinition"
        ? (parse(raw).definitions[0] as any).name?.value ?? "anonymous"
        : "anonymous";

    entries.push({ hash, query: normalized, operationName });
  }

  await writeFile(
    "dist/persisted-queries.json",
    JSON.stringify(entries, null, 2),
  );
}

buildManifest().catch((err) => {
  console.error("Failed to build persisted query manifest:", err);
  process.exit(1);
});
Dieses Manifest wird als Teil des Deployments an den Server ausgeliefert — nicht als Datenbank-Eintrag, den ein Angreifer vergiften könnte, sondern als Build-Artefakt, das an ein bestimmtes Client-Release gebunden ist.
Die Allowlist serverseitig durchsetzen
Die serverseitige Prüfung ist bewusst langweilig: Hash nachschlagen, ablehnen falls nicht vorhanden, gespeicherte Query mit den vom Client gelieferten Variablen ausführen.
import type { Request, Response, NextFunction } from "express";
import manifest from "./dist/persisted-queries.json";

const allowlist = new Map(
  manifest.map((entry) => [entry.hash, entry.query]),
);

export function persistedQueryGuard(
  req: Request,
  res: Response,
  next: NextFunction,
): void {
  const { id, query, variables } = req.body;

  // ❌ Never fall back to executing an inline query
  // in production once the allowlist is enforced.
  if (!id) {
    res.status(400).json({ errors: [{ message: "Missing query id" }] });
    return;
  }

  const resolvedQuery = allowlist.get(id);
  if (!resolvedQuery) {
    res.status(400).json({
      errors: [{ message: "Unknown persisted query", code: "PERSISTED_QUERY_NOT_FOUND" }],
    });
    return;
  }

  req.body = { query: resolvedQuery, variables };
  next();
}
Der Fehlercode PERSISTED_QUERY_NOT_FOUND entspricht der Konvention, die Apollo-Clients bereits kennen, sodass bestehende Client-Bibliotheken sauber degradieren, statt bei einer unbekannten Form einfach zu crashen.
Die Durchsetzung der Allowlist zahlt sich nur aus, wenn Introspection in Produktion ebenfalls deaktiviert ist. Eine vollständig abgeriegelte Operationsliste neben einer offenen __schema-Query legt trotzdem deine gesamte API-Oberfläche offen.
Mutations in cachebare GET-Requests verwandeln
Da ein Persisted-Query-Identifier zusammen mit seinen Variablen die Antwort für eine gegebene Query vollständig festlegt, kannst du Lese-Operationen als GET-Requests mit Hash und Variablen im Query-String senden, statt in einem POST-Body. Diese einzige Änderung macht GraphQL-Antworten für jeden Standard-HTTP-Cache cachebar — einen CDN, einen Reverse-Proxy, sogar den Browser — mit derselben Cache-Control-Semantik, wie sie in RFC 9111 definiert ist.
# ✅ Cacheable: deterministic URL, standard HTTP caching applies
curl "https://api.example.com/graphql?\
id=a13f9e2c8b7d4f0e1a9c8b7d4f0e1a9c&\
variables=%7B%22userId%22%3A%22usr_8821%22%7D"# ❌ Not cacheable by anything downstream of your app server
curl -X POST https://api.example.com/graphql \
-d '{"query": "query GetDashboard($userId: ID!) { ... }"}'Ein CDN kann diese GET-Antwort jetzt anhand der vollständigen URL cachen, dir Edge-Level-Hitrates für deine meistgenutzten Lese-Queries verschaffen und echte Latenz bei allem einsparen, was nicht pro Request frisch sein muss.
Rollout, ohne bestehende Clients zu brechen
Die Allowlist-Durchsetzung für alle Clients auf einmal einzuschalten, ist der sichere Weg, Produktion lahmzulegen. Rolle es in drei Stufen aus:
- Zuerst APQ deployen. Keine Allowlist-Durchsetzung, nur hash-basiertes Caching. Das validiert die Hashing- und Fallback-Logik ohne jedes Risiko.
- Unbekannte Hashes loggen statt ablehnen. Lass die Allowlist-Prüfung einen Release-Zyklus lang im Shadow-Modus laufen, um Clients zu erwischen, die du vergessen hast neu zu bauen — insbesondere alte Mobile-App-Versionen.
- Durchsetzen, mit dokumentierter Mindest-Client-Version. Sobald die Logs für die Versionen, die du unterstützen willst, eine Rate unbekannter Hashes von null zeigen, schaltest du die Prüfung auf Ablehnung um.
Wichtigste Erkenntnisse
- Persisted Queries ersetzen vollständige Query-Dokumente durch kurze Hashes und reduzieren so die Payload-Größe bei jeder Anfrage nach der ersten.
- Automatic Persisted Queries bringen einen Bandbreitengewinn; eine Build-Time-Allowlist ist die Variante, die tatsächlich die Sicherheit verbessert.
- Normalisiere den Query-Text (über
print(parse(query))) vor dem Hashing, damit semantisch identische Queries immer zu einem Eintrag zusammenfallen. - Deaktiviere Introspection zusammen mit der Allowlist-Durchsetzung — ohne das eine bleibt dein Schema trotzdem auffindbar.
- Das Umwandeln persistierter Reads in
GET-Requests erschließt Standard-HTTP- und CDN-Caching, das reinesPOST-GraphQL nie bekommt. - Rolle die Durchsetzung zuerst im Shadow-Modus aus; ein harter Umstieg auf eine ungeloggte Allowlist bricht stillschweigend genau den Client, den du vergessen hast.