Eine Task Queue von Grund auf mit Node.js und Redis bauen
Baue Schritt für Schritt eine produktionsreife Task Queue mit Node.js und Redis: zuverlässige Zustellung, Retries, Dead Letter Queues, Nebenläufigkeit.

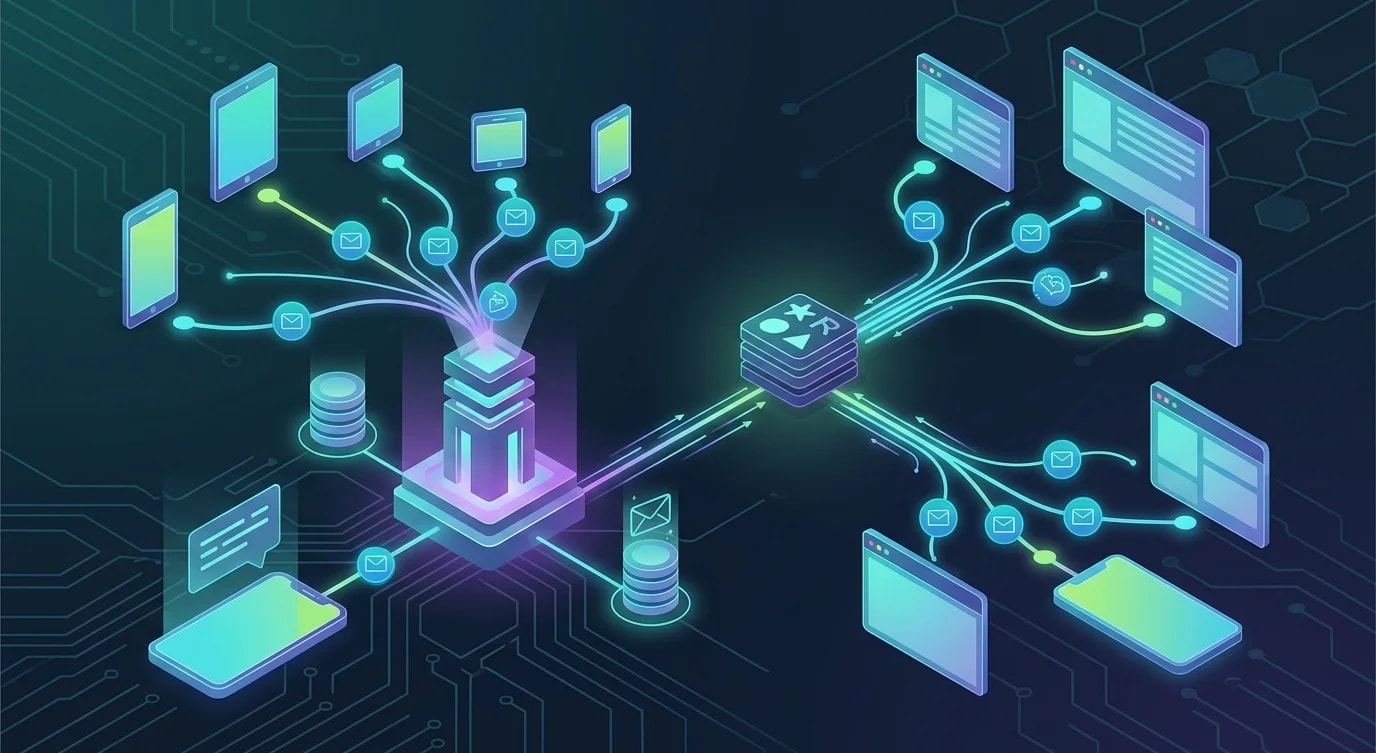
Jede Anwendung braucht irgendwann Hintergrundverarbeitung. E-Mail-Benachrichtigungen, Bildskalierung, Report-Generierung, Webhook-Zustellung — diese Aufgaben gehören nicht in den Request-Response-Zyklus. Eine Task Queue entkoppelt Produzenten von Konsumenten und ermöglicht zuverlässige asynchrone Verarbeitung.
Auch wenn es Bibliotheken wie BullMQ gibt: Eine Queue von Grund auf zu bauen lehrt dich die Primitive, auf denen verteilte Jobverarbeitung basiert. Du verstehst genau, was passiert, wenn ein Job fehlschlägt, wie Nebenläufigkeit gesteuert wird und warum bestimmte Designentscheidungen wichtig sind.
Die grundlegende Queue-Struktur
Eine Task Queue braucht drei Dinge: eine Möglichkeit, Jobs einzureihen, eine Möglichkeit, sie zuverlässig zu entnehmen, und eine Möglichkeit, ihren Zustand zu verfolgen. Redis liefert alle Bausteine.
import { createClient, RedisClientType } from "redis";

interface Job<T = unknown> {
  id: string;
  queue: string;
  payload: T;
  attempts: number;
  maxAttempts: number;
  createdAt: number;
  processAfter: number;
}

class TaskQueue {
  private client: RedisClientType;
  private prefix: string;

  constructor(client: RedisClientType, prefix: string = "tq") {
    this.client = client;
    this.prefix = prefix;
  }

  private key(queue: string, suffix: string): string {
    return `${this.prefix}:${queue}:${suffix}`;
  }

  async enqueue<T>(
    queue: string,
    payload: T,
    options: { delay?: number; maxAttempts?: number } = {}
  ): Promise<string> {
    const id = crypto.randomUUID();
    const now = Date.now();

    const job: Job<T> = {
      id,
      queue,
      payload,
      attempts: 0,
      maxAttempts: options.maxAttempts ?? 3,
      createdAt: now,
      processAfter: now + (options.delay ?? 0),
    };

    const multi = this.client.multi();

    // Store job data
    multi.set(
      this.key(queue, `job:${id}`),
      JSON.stringify(job)
    );

    // Add to waiting sorted set (scored by processAfter)
    multi.zAdd(this.key(queue, "waiting"), {
      score: job.processAfter,
      value: id,
    });

    await multi.exec();
    return id;
  }
}
Ein Sorted Set für die Warteschlange ermöglicht verzögerte Jobs ganz natürlich: Jobs werden nach ihrem processAfter-Zeitstempel bewertet, sodass wir nur Jobs aufnehmen, deren Score den aktuellen Zeitpunkt erreicht hat oder davor liegt.
Zuverlässige Job-Entnahme
Die entscheidende Herausforderung bei jeder Queue ist die Exactly-Once-Verarbeitung. Stürzt ein Worker mitten in einem Job ab, darf der Job nicht verloren gehen. Redis' ZPOPMIN kombiniert mit einem Processing-Set stellt diese Garantie bereit.
// ❌ Unreliable: job lost if worker crashes after pop
async function unsafeDequeue(client: RedisClientType, queue: string) {
  const result = await client.zPopMin(queue);
  // If process crashes here, job is gone forever
  return result;
}// ✅ Reliable: job tracked in processing set
class TaskQueue {
// ... previous code
async dequeue(queue: string): Promise<Job | null> {
const now = Date.now();
const waitingKey = this.key(queue, "waiting");
const processingKey = this.key(queue, "processing");
// Atomically move job from waiting to processing
const script = `
local result = redis.call('ZRANGEBYSCORE', KEYS[1], '-inf', ARGV[1], 'LIMIT', 0, 1)
if #result == 0 then return nil end
local jobId = result[1]
redis.call('ZREM', KEYS[1], jobId)
redis.call('ZADD', KEYS[2], ARGV[2], jobId)
return jobId
`;
const jobId = await this.client.eval(script, {
keys: [waitingKey, processingKey],
arguments: [String(now), String(now)],
});
if (!jobId) return null;
const jobData = await this.client.get(
this.key(queue, `job:${jobId}`)
);
if (!jobData) return null;
return JSON.parse(jobData) as Job;
}
async acknowledge(queue: string, jobId: string): Promise<void> {
const multi = this.client.multi();
multi.zRem(this.key(queue, "processing"), jobId);
multi.del(this.key(queue, `job:${jobId}`));
multi.incr(this.key(queue, "stats:completed"));
await multi.exec();
}
}Das Lua-Skript läuft atomar in Redis — kein anderer Client kann zwischen der Prüfung des Warte-Sets und dem Verschieben des Jobs ins Processing-Set dazwischenfunken. Damit ist die Race Condition ausgeschlossen, bei der zwei Worker denselben Job greifen könnten.
Retry-Logik und Dead Letter Queues
Jobs schlagen fehl. Netzwerke laufen in Timeouts, externe APIs liefern Fehler, Daten sind fehlerhaft. Eine robuste Queue wiederholt vorübergehende Fehler und leitet dauerhafte Fehler zur Untersuchung in eine Dead Letter Queue weiter.
class TaskQueue {
  // ... previous code

  async fail(
    queue: string,
    jobId: string,
    error: string
  ): Promise<"retried" | "dead-lettered"> {
    const jobData = await this.client.get(
      this.key(queue, `job:${jobId}`)
    );

    if (!jobData) throw new Error(`Job ${jobId} not found`);

    const job: Job = JSON.parse(jobData);
    job.attempts += 1;

    // Remove from processing set
    await this.client.zRem(this.key(queue, "processing"), jobId);

    if (job.attempts < job.maxAttempts) {
      // Exponential backoff: 1s, 4s, 9s, 16s...
      const delay = Math.pow(job.attempts, 2) * 1000;
      job.processAfter = Date.now() + delay;

      const multi = this.client.multi();
      multi.set(
        this.key(queue, `job:${jobId}`),
        JSON.stringify(job)
      );
      multi.zAdd(this.key(queue, "waiting"), {
        score: job.processAfter,
        value: jobId,
      });
      await multi.exec();

      return "retried";
    }

    // Max attempts exceeded: dead letter queue
    const multi = this.client.multi();
    multi.lPush(
      this.key(queue, "dead"),
      JSON.stringify({ ...job, error, failedAt: Date.now() })
    );
    multi.del(this.key(queue, `job:${jobId}`));
    multi.incr(this.key(queue, "stats:dead-lettered"));
    await multi.exec();

    return "dead-lettered";
  }
}
Exponentielles Backoff mit der Formel attempts² × 1000ms ergibt immer längere Wartezeiten: 1 Sekunde, 4 Sekunden, 9 Sekunden. Das verhindert Retry-Stürme, wenn ein nachgelagerter Dienst kämpft, und gibt ihm Zeit zur Erholung.
Die Worker-Schleife bauen
Ein Worker fragt kontinuierlich Jobs ab, verarbeitet sie und behandelt Erfolg oder Fehlschlag. Das Polling-Intervall balanciert Reaktionsfähigkeit gegen Redis-Last aus.
type JobHandler<T = unknown> = (payload: T) => Promise<void>;

class Worker {
  private queue: TaskQueue;
  private queueName: string;
  private handler: JobHandler;
  private running: boolean = false;
  private concurrency: number;
  private activeJobs: number = 0;

  constructor(
    queue: TaskQueue,
    queueName: string,
    handler: JobHandler,
    concurrency: number = 5
  ) {
    this.queue = queue;
    this.queueName = queueName;
    this.handler = handler;
    this.concurrency = concurrency;
  }

  async start(): Promise<void> {
    this.running = true;
    console.log(
      `Worker started for queue "${this.queueName}" ` +
      `(concurrency: ${this.concurrency})`
    );

    while (this.running) {
      if (this.activeJobs >= this.concurrency) {
        await this.sleep(100);
        continue;
      }

      const job = await this.queue.dequeue(this.queueName);

      if (!job) {
        await this.sleep(1000); // No jobs available, wait
        continue;
      }

      this.activeJobs++;
      this.processJob(job).finally(() => {
        this.activeJobs--;
      });
    }
  }

  private async processJob(job: Job): Promise<void> {
    try {
      await this.handler(job.payload);
      await this.queue.acknowledge(this.queueName, job.id);
    } catch (error) {
      const message =
        error instanceof Error ? error.message : "Unknown error";
      const result = await this.queue.fail(
        this.queueName,
        job.id,
        message
      );
      console.warn(
        `Job ${job.id} failed (${result}): ${message}`
      );
    }
  }

  stop(): void {
    this.running = false;
  }

  private sleep(ms: number): Promise<void> {
    return new Promise(resolve => setTimeout(resolve, ms));
  }
}
Die Nebenläufigkeitssteuerung stellt sicher, dass der Worker mehrere Jobs gleichzeitig verarbeitet, ohne das System zu überlasten. Jeder Job läuft unabhängig — ein langsamer Job blockiert die anderen nicht.
Wiederherstellung hängengebliebener Jobs
Stürzt ein Worker ab, bleiben seine Jobs auf unbestimmte Zeit im Processing-Set. Ein separater Recovery-Prozess muss hängengebliebene Jobs erkennen und erneut einreihen.
class TaskQueue {
  // ... previous code

  async recoverStalledJobs(
    queue: string,
    stallTimeout: number = 30000
  ): Promise<number> {
    const processingKey = this.key(queue, "processing");
    const cutoff = Date.now() - stallTimeout;

    // Find jobs that have been processing longer than stallTimeout
    const stalledIds = await this.client.zRangeByScore(
      processingKey,
      "-inf",
      String(cutoff)
    );

    let recovered = 0;

    for (const jobId of stalledIds) {
      const jobData = await this.client.get(
        this.key(queue, `job:${jobId}`)
      );

      if (!jobData) {
        // Job data missing, just clean up
        await this.client.zRem(processingKey, jobId);
        continue;
      }

      const job: Job = JSON.parse(jobData);
      job.attempts += 1;

      if (job.attempts >= job.maxAttempts) {
        // Exceeded retries, dead letter it
        const multi = this.client.multi();
        multi.zRem(processingKey, jobId);
        multi.lPush(
          this.key(queue, "dead"),
          JSON.stringify({
            ...job,
            error: "Stalled and exceeded max attempts",
            failedAt: Date.now(),
          })
        );
        multi.del(this.key(queue, `job:${jobId}`));
        await multi.exec();
      } else {
        // Re-enqueue for retry
        const multi = this.client.multi();
        multi.zRem(processingKey, jobId);
        multi.set(
          this.key(queue, `job:${jobId}`),
          JSON.stringify(job)
        );
        multi.zAdd(this.key(queue, "waiting"), {
          score: Date.now(),
          value: jobId,
        });
        await multi.exec();
        recovered++;
      }
    }

    return recovered;
  }
}
Führe den Recovery-Lauf per Timer aus — alle 30 Sekunden ist für die meisten Anwendungen ein sinnvoller Wert. Der Stall-Timeout sollte länger sein als die längste erwartete Jobdauer, damit keine Jobs wiederhergestellt werden, die noch aktiv verarbeitet werden.
Alles zusammenführen
So interagieren Produzenten und Konsumenten in einem realen Anwendungsszenario über die Queue.
async function main() {
  const redis = createClient({ url: "redis://localhost:6379" });
  await redis.connect();

  const taskQueue = new TaskQueue(redis);

  // Producer: enqueue email jobs
  await taskQueue.enqueue("emails", {
    to: "user@example.com",
    subject: "Welcome",
    template: "onboarding",
  });

  await taskQueue.enqueue(
    "emails",
    {
      to: "admin@example.com",
      subject: "Daily Report",
      template: "report",
    },
    { delay: 60000 } // Delay 1 minute
  );

  // Consumer: process email jobs
  const worker = new Worker(
    taskQueue,
    "emails",
    async (payload) => {
      const emailPayload = payload as {
        to: string;
        subject: string;
        template: string;
      };
      console.log(`Sending email to ${emailPayload.to}`);
      // await sendEmail(emailPayload);
    },
    3 // Process 3 emails concurrently
  );

  // Start stall recovery on interval
  setInterval(() => {
    taskQueue.recoverStalledJobs("emails").then(count => {
      if (count > 0) console.log(`Recovered ${count} stalled jobs`);
    });
  }, 30000);

  await worker.start();
}
Die wichtigsten Erkenntnisse
Eine Task Queue von Grund auf zu bauen offenbart die Komplexität, die hinter einfach aussehenden Jobverarbeitungs-APIs steckt. Die zentralen Herausforderungen liegen nicht im Einreihen von Daten — sie liegen in den Zuverlässigkeitsgarantien. Atomare Zustandsübergänge von Jobs verhindern Duplikate. Exponentielles Backoff verhindert Retry-Stürme. Dead Letter Queues verhindern stillen Datenverlust. Die Stall-Recovery verhindert, dass Jobs verschwinden, wenn Worker abstürzen.
Das Verständnis dieser Primitive macht dich zu einem besseren Nutzer von produktiven Queue-Bibliotheken und gibt dir die Grundlage, um Probleme zu debuggen, die in verteilten Jobverarbeitungssystemen unweigerlich auftreten.