Sistemas tolerantes a fallos con degradación gradual
Ingeniería de tolerancia a fallos: circuit breakers, bulkheads, cadenas de fallback y degradación que mantienen el sistema útil cuando algo falla.
La diferencia entre fallo e interrupción
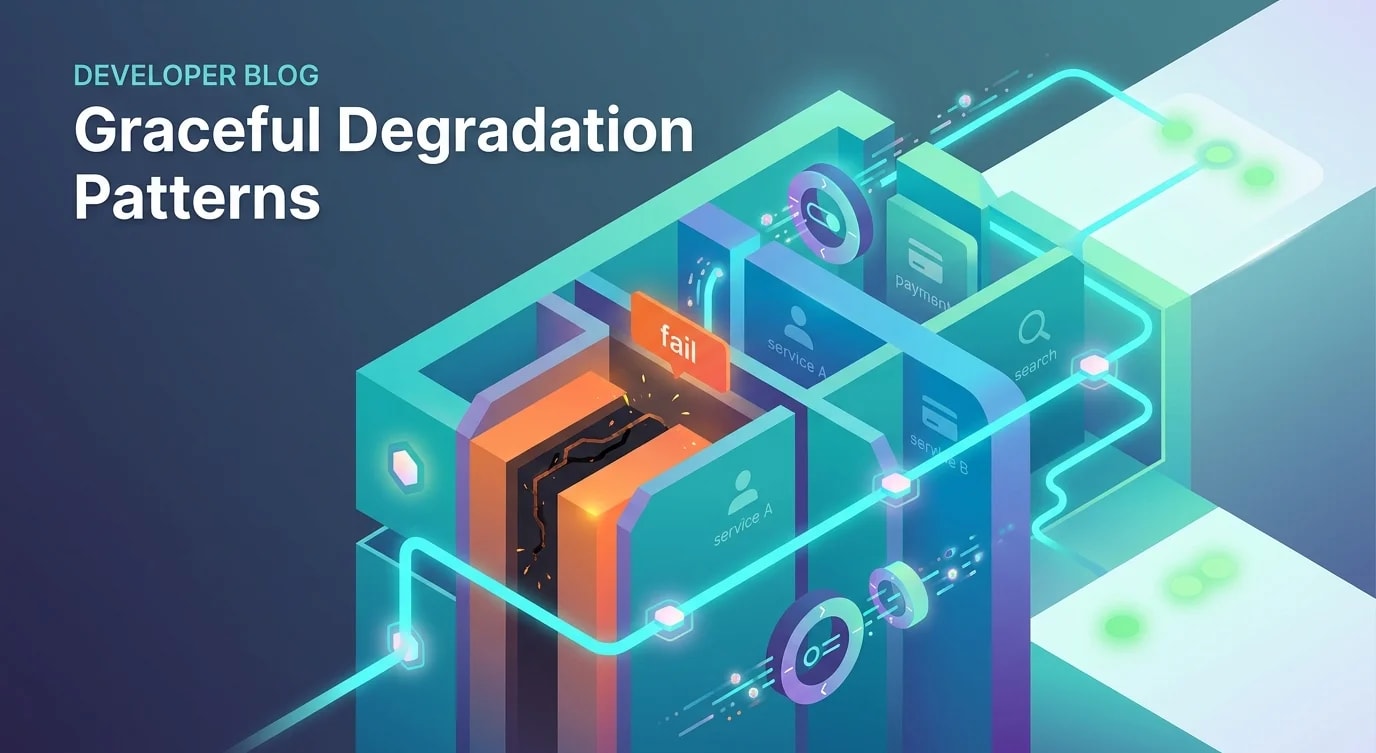
Todo sistema falla. La distinción entre un sistema resiliente y uno frágil no está en si ocurren fallos, sino en si los fallos de componentes individuales se propagan hasta provocar interrupciones totales. Si un servicio de pagos deja de funcionar, los usuarios deberían seguir pudiendo navegar por los productos. Si un motor de recomendaciones supera el tiempo de espera, el flujo de compra no debería bloquearse.
La degradación gradual es la práctica de diseñar sistemas que siguen siendo útiles —aunque con capacidad reducida— cuando partes de ellos fallan. Requiere pensar en los modos de fallo durante el diseño, no como algo secundario durante la respuesta a incidentes.
Implementación del circuit breaker
El patrón circuit breaker evita que una dependencia en fallo consuma recursos y propague errores a componentes sanos. Cuando un servicio empieza a fallar, el circuito se abre y devuelve respuestas de fallback inmediatamente, en lugar de esperar a los tiempos de espera.
enum CircuitState {
  CLOSED = "CLOSED",
  OPEN = "OPEN",
  HALF_OPEN = "HALF_OPEN",
}

interface CircuitBreakerConfig {
  failureThreshold: number;
  resetTimeout: number;
  halfOpenRequests: number;
}

class CircuitBreaker<T> {
  private state: CircuitState = CircuitState.CLOSED;
  private failureCount = 0;
  private lastFailureTime = 0;
  private halfOpenAttempts = 0;

  constructor(
    private readonly action: () => Promise<T>,
    private readonly fallback: () => T,
    private readonly config: CircuitBreakerConfig
  ) {}

  async execute(): Promise<T> {
    if (this.state === CircuitState.OPEN) {
      if (Date.now() - this.lastFailureTime > this.config.resetTimeout) {
        this.state = CircuitState.HALF_OPEN;
        this.halfOpenAttempts = 0;
      } else {
        return this.fallback();
      }
    }

    try {
      const result = await this.action();
      this.onSuccess();
      return result;
    } catch (error) {
      this.onFailure();
      return this.fallback();
    }
  }

  private onSuccess(): void {
    this.failureCount = 0;
    if (this.state === CircuitState.HALF_OPEN) {
      this.halfOpenAttempts++;
      if (this.halfOpenAttempts >= this.config.halfOpenRequests) {
        this.state = CircuitState.CLOSED;
      }
    }
  }

  private onFailure(): void {
    this.failureCount++;
    this.lastFailureTime = Date.now();
    if (this.failureCount >= this.config.failureThreshold) {
      this.state = CircuitState.OPEN;
    }
  }

  getState(): CircuitState {
    return this.state;
  }
}
El circuit breaker opera en tres estados: cerrado (operación normal), abierto (todas las peticiones se derivan al fallback) y semiabierto (peticiones de prueba limitadas para comprobar si el servicio se ha recuperado).
Patrón bulkhead para aislamiento de recursos
Los bulkheads aíslan los fallos dividiendo los recursos en particiones, de modo que un problema en una zona no pueda agotar los recursos que necesita otra.
// ❌ Shared connection pool — one slow service blocks everything
class SharedPool {
  private connections = 0;
  private readonly maxConnections = 100;

  async request(service: string): Promise<Response> {
    if (this.connections >= this.maxConnections) {
      throw new Error("Pool exhausted — ALL services affected");
    }
    this.connections++;
    try {
      return await fetch(`https://${service}/api`);
    } finally {
      this.connections--;
    }
  }
}

// ✅ Bulkheaded pools — failures are contained per service
interface BulkheadConfig {
  maxConcurrent: number;
  queueSize: number;
}

class Bulkhead {
  private active = 0;
  private queue: Array<() => void> = [];

  constructor(
    private readonly name: string,
    private readonly config: BulkheadConfig
  ) {}

  async execute<T>(fn: () => Promise<T>): Promise<T> {
    if (this.active >= this.config.maxConcurrent) {
      if (this.queue.length >= this.config.queueSize) {
        throw new Error(
          `Bulkhead '${this.name}' full: ${this.active} active, ${this.queue.length} queued`
        );
      }

      await new Promise<void>((resolve) => {
        this.queue.push(resolve);
      });
    }

    this.active++;
    try {
      return await fn();
    } finally {
      this.active--;
      const next = this.queue.shift();
      if (next) next();
    }
  }
}

// Each service gets its own resource budget
const bulkheads = {
  payments: new Bulkhead("payments", { maxConcurrent: 30, queueSize: 10 }),
  inventory: new Bulkhead("inventory", { maxConcurrent: 20, queueSize: 50 }),
  recommendations: new Bulkhead("recommendations", {
    maxConcurrent: 10,
    queueSize: 5,
  }),
};
Cuando el servicio de recomendaciones se ralentiza, solo puede consumir sus 10 conexiones concurrentes asignadas. Los pagos y el inventario siguen funcionando con normalidad gracias a sus propios pools.
Arquitectura de cadenas de fallback
Un único fallback rara vez es suficiente. Los sistemas en producción necesitan estrategias de fallback en capas que prueben aproximaciones progresivamente más simples antes de rendirse por completo.
interface FallbackStep<T> {
  name: string;
  execute: () => Promise<T>;
  timeout: number;
}

async function executeFallbackChain<T>(
  steps: FallbackStep<T>[],
  onStepFailed?: (step: string, error: Error) => void
): Promise<T> {
  for (const step of steps) {
    try {
      const result = await Promise.race([
        step.execute(),
        new Promise<never>((_, reject) =>
          setTimeout(() => reject(new Error("Timeout")), step.timeout)
        ),
      ]);
      return result;
    } catch (error) {
      onStepFailed?.(step.name, error as Error);
      continue;
    }
  }
  throw new Error("All fallback steps exhausted");
}

// Product pricing with layered fallbacks
interface ProductPrice {
  amount: number;
  currency: string;
  source: string;
}

const pricingChain: FallbackStep<ProductPrice>[] = [
  {
    name: "real-time-pricing-service",
    execute: async () => {
      const res = await fetch("https://pricing.internal/api/price");
      return { ...(await res.json()), source: "real-time" };
    },
    timeout: 500,
  },
  {
    name: "cached-pricing",
    execute: async () => {
      const cached = await redis.get("product:price:123");
      if (!cached) throw new Error("Cache miss");
      return { ...JSON.parse(cached), source: "cache" };
    },
    timeout: 100,
  },
  {
    name: "last-known-price-from-db",
    execute: async () => {
      const row = await db.query("SELECT price FROM products WHERE id = $1", [
        123,
      ]);
      return { amount: row.price, currency: "USD", source: "database" };
    },
    timeout: 2000,
  },
];
La cadena de fallback degrada desde precios en tiempo real a precios en caché y, finalmente, a precios de base de datos. Cada paso es progresivamente más lento pero más fiable. El consumidor recibe los mejores datos disponibles con un campo source que indica la frescura.
Mapeo de degradación de funcionalidades
No todas las funcionalidades tienen la misma importancia. Mapea las funcionalidades de tu sistema según su criticidad para el negocio y define modos degradados para cada nivel.
enum FeatureTier {
  CRITICAL = "critical",
  IMPORTANT = "important",
  NICE_TO_HAVE = "nice-to-have",
}

interface FeatureDegradationPlan {
  feature: string;
  tier: FeatureTier;
  normalBehavior: string;
  degradedBehavior: string;
  dependencies: string[];
}

const degradationPlan: FeatureDegradationPlan[] = [
  {
    feature: "Checkout",
    tier: FeatureTier.CRITICAL,
    normalBehavior: "Full payment processing with fraud detection",
    degradedBehavior: "Process payments, skip fraud scoring, flag for manual review",
    dependencies: ["payment-gateway", "fraud-service", "inventory-service"],
  },
  {
    feature: "Product search",
    tier: FeatureTier.IMPORTANT,
    normalBehavior: "Full-text search with personalized ranking",
    degradedBehavior: "Basic search without personalization, category browsing only",
    dependencies: ["search-service", "personalization-engine"],
  },
  {
    feature: "Recommendations",
    tier: FeatureTier.NICE_TO_HAVE,
    normalBehavior: "ML-powered personalized recommendations",
    degradedBehavior: "Show trending/popular items from static cache",
    dependencies: ["recommendation-service", "user-profile-service"],
  },
];

function getActiveFeatures(
  healthyServices: Set<string>
): Map<string, string> {
  const activeFeatures = new Map<string, string>();

  for (const plan of degradationPlan) {
    const allHealthy = plan.dependencies.every((dep) =>
      healthyServices.has(dep)
    );

    const criticalDepsHealthy = plan.dependencies
      .slice(0, 1)
      .every((dep) => healthyServices.has(dep));

    if (allHealthy) {
      activeFeatures.set(plan.feature, "normal");
    } else if (criticalDepsHealthy || plan.tier === FeatureTier.CRITICAL) {
      activeFeatures.set(plan.feature, "degraded");
    } else {
      activeFeatures.set(plan.feature, "disabled");
    }
  }

  return activeFeatures;
}
Health checks y monitorización de dependencias
Los health checks proactivos permiten la degradación gradual antes de que los usuarios sufran fallos.
interface HealthCheckResult {
  service: string;
  status: "healthy" | "degraded" | "unhealthy";
  latencyMs: number;
  lastChecked: Date;
  consecutiveFailures: number;
}

class DependencyMonitor {
  private results = new Map<string, HealthCheckResult>();
  private intervals = new Map<string, NodeJS.Timeout>();

  registerCheck(
    service: string,
    check: () => Promise<void>,
    intervalMs: number
  ): void {
    const runCheck = async (): Promise<void> => {
      const start = Date.now();
      const previous = this.results.get(service);

      try {
        await Promise.race([
          check(),
          new Promise<never>((_, reject) =>
            setTimeout(() => reject(new Error("Health check timeout")), 5000)
          ),
        ]);

        this.results.set(service, {
          service,
          status: "healthy",
          latencyMs: Date.now() - start,
          lastChecked: new Date(),
          consecutiveFailures: 0,
        });
      } catch {
        const failures = (previous?.consecutiveFailures ?? 0) + 1;
        this.results.set(service, {
          service,
          status: failures >= 3 ? "unhealthy" : "degraded",
          latencyMs: Date.now() - start,
          lastChecked: new Date(),
          consecutiveFailures: failures,
        });
      }
    };

    runCheck();
    this.intervals.set(service, setInterval(runCheck, intervalMs));
  }

  getHealthyServices(): Set<string> {
    const healthy = new Set<string>();
    for (const [service, result] of this.results) {
      if (result.status !== "unhealthy") {
        healthy.add(service);
      }
    }
    return healthy;
  }

  shutdown(): void {
    for (const interval of this.intervals.values()) {
      clearInterval(interval);
    }
  }
}
Conclusiones clave
La tolerancia a fallos es una decisión de diseño, no un problema de despliegue. Los circuit breakers evitan fallos en cascada acortando las llamadas a servicios no saludables. Los bulkheads aíslan el consumo de recursos para que una dependencia en fallo no agote los recursos que necesitan otras. Las cadenas de fallback ofrecen respuestas progresivamente más simples cuando las fuentes principales no están disponibles.
Mapea tus funcionalidades según la criticidad del negocio y define estados degradados aceptables para cada una. El objetivo no es una disponibilidad perfecta para cada funcionalidad, sino garantizar que los caminos críticos sigan operativos incluso cuando fallen los servicios de soporte. Un sistema que sigue procesando pedidos con recomendaciones degradadas es infinitamente más valioso que uno que se apaga por completo porque el motor de recomendaciones superó el tiempo de espera.