Message Queues in der Praxis
RabbitMQ, Redis Streams oder Kafka — die Messaging-Patterns hinter entkoppelten, robusten Systemen und wann sich welches Tool eignet.

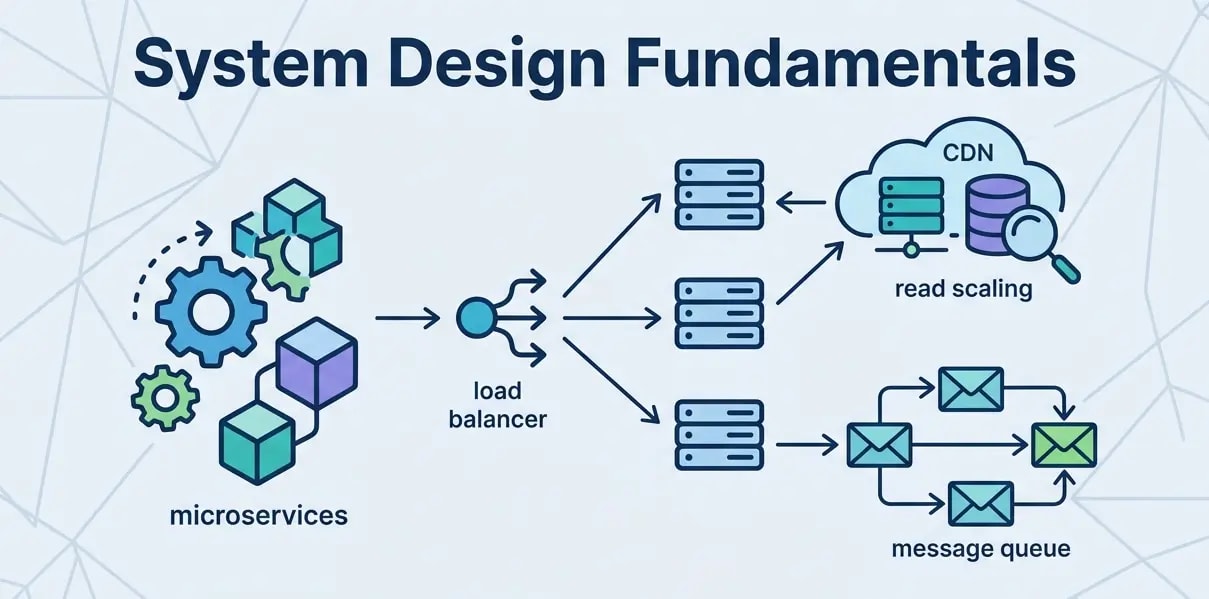
Message Queues sind das Rückgrat verteilter Systeme. Sie entkoppeln Producer von Consumern, fangen Traffic-Spitzen ab und ermöglichen zuverlässige Kommunikation zwischen Services, die nicht gleichzeitig online sein müssen. Wer sich jedoch zwischen RabbitMQ, Kafka, Redis Streams oder SQS entscheidet, ohne die zugrunde liegenden Muster zu verstehen, landet schnell bei überkonstruierten Lösungen.
Punkt-zu-Punkt vs. Pub/Sub
Jedes Messaging-Muster lässt sich einer von zwei Kategorien zuordnen.
// Point-to-point: one message, one consumer
// Use case: task distribution (send email, process payment)
// Each message is processed by exactly ONE worker

// Pub/Sub: one message, many consumers
// Use case: event broadcasting (order placed → notify analytics, inventory, email)
// Each message is delivered to ALL subscribers| Muster | Zustellung | Consumer | Beispiel |
|---|---|---|---|
| Punkt-zu-Punkt | Ein Consumer pro Nachricht | Konkurrierende Worker | Job-Queues, Aufgabenverteilung |
| Pub/Sub | Alle Subscriber | Unabhängige Consumer | Event-Broadcasting, Benachrichtigungen |
| Fan-out | Alle Consumer, jeder erhält eine Kopie | Unabhängige Verarbeitung | Synchronisation mehrerer Systeme |
Wann du eine Message Queue brauchst
Nicht jede Interaktion zwischen Services braucht eine Queue. Direkte HTTP-Aufrufe eignen sich, wenn:
- die Antwort sofort benötigt wird
- beide Services verfügbar sein müssen
- ein Fehler für den Aufrufer sichtbar sein soll
Queues bringen Mehrwert, wenn:
- sich die Arbeit aufschieben lässt
- die Services unterschiedliche Verfügbarkeitsanforderungen haben
- der Traffic in Schüben auftritt und gepuffert werden muss
// ❌ Synchronous chain — one failure breaks everything
app.post("/api/orders", async (req, res) => {
  const order = await createOrder(req.body);
  await inventoryService.reserve(order.items);      // If this fails...
  await paymentService.charge(order.total);          // ...none of this runs
  await emailService.sendConfirmation(order);        // ...the user sees an error
  await analyticsService.trackPurchase(order);
  res.json(order);
});

// ✅ Async event — order is placed, downstream services react independently
app.post("/api/orders", async (req, res) => {
  const order = await createOrder(req.body);

  await messageQueue.publish("order.placed", {
    orderId: order.id,
    items: order.items,
    total: order.total,
    customerId: order.customerId,
  });

  res.json(order);
});

// Each service consumes the event independently
// inventory-service listens to "order.placed"
// payment-service listens to "order.placed"
// email-service listens to "order.placed"
// analytics-service listens to "order.placed"
Zustellgarantien
Messaging-Systeme bieten unterschiedliche Stufen der Zustellzuverlässigkeit.
// At-most-once: fire and forget
// Message may be lost, but never duplicated
// Use for: metrics, logging, non-critical notifications

// At-least-once: guaranteed delivery, possible duplicates
// Consumer MUST be idempotent
// Use for: most business events (payments, emails, orders)

// Exactly-once: no loss, no duplicates (very expensive)
// Requires distributed transactions or deduplication
// Use for: financial transactions (or use at-least-once + idempotency)
In der Praxis ist at-least-once mit idempotenten Consumern die richtige Standardwahl. Exactly-once-Zustellung ist eine theoretische Garantie, die in der korrekten Umsetzung extrem aufwendig ist.
RabbitMQ: der klassische Message-Broker
RabbitMQ punktet bei Routing, Acknowledgment und Punkt-zu-Punkt-Queuing.
import amqp from "amqplib";

// Producer
async function publishOrderEvent(order: Order) {
  const connection = await amqp.connect(process.env.RABBITMQ_URL!);
  const channel = await connection.createChannel();

  await channel.assertExchange("orders", "topic", { durable: true });

  channel.publish(
    "orders",
    "order.placed",
    Buffer.from(JSON.stringify(order)),
    { persistent: true }, // Survive broker restarts
  );
}

// Consumer
async function startOrderConsumer() {
  const connection = await amqp.connect(process.env.RABBITMQ_URL!);
  const channel = await connection.createChannel();

  await channel.assertExchange("orders", "topic", { durable: true });
  const queue = await channel.assertQueue("inventory-service", {
    durable: true,
  });
  await channel.bindQueue(queue.queue, "orders", "order.placed");

  channel.prefetch(10); // Process 10 messages at a time

  channel.consume(queue.queue, async (msg) => {
    if (!msg) return;

    try {
      const order = JSON.parse(msg.content.toString());
      await reserveInventory(order);
      channel.ack(msg); // Acknowledge successful processing
    } catch (error) {
      channel.nack(msg, false, true); // Requeue on failure
    }
  });
}
Kafka: Event-Streaming
Kafka ist keine klassische Queue, sondern ein verteiltes Commit-Log. Nachrichten werden dauerhaft gespeichert und lassen sich erneut abspielen.
import { Kafka } from "kafkajs";

const kafka = new Kafka({
  clientId: "order-service",
  brokers: [process.env.KAFKA_BROKER!],
});

// Producer
const producer = kafka.producer();
await producer.connect();

await producer.send({
  topic: "orders",
  messages: [
    {
      key: order.id, // Partition by order ID for ordering guarantees
      value: JSON.stringify({ event: "order.placed", data: order }),
    },
  ],
});

// Consumer group — messages distributed among group members
const consumer = kafka.consumer({ groupId: "inventory-service" });
await consumer.connect();
await consumer.subscribe({ topic: "orders", fromBeginning: false });

await consumer.run({
  eachMessage: async ({ topic, partition, message }) => {
    const event = JSON.parse(message.value!.toString());

    if (event.event === "order.placed") {
      await reserveInventory(event.data);
    }
  },
});
Das richtige Tool wählen
| Feature | RabbitMQ | Kafka | Redis Streams | SQS |
|---|---|---|---|---|
| Routing | Fortgeschritten (Exchanges, Bindings) | Topics + Partitionen | Einfach | Grundlegend |
| Message Replay | Nein (konsumiert = weg) | Ja (persistentes Log) | Eingeschränkt | Nein |
| Durchsatz | ~50K msg/s | ~1M msg/s | ~100K msg/s | ~3K msg/s |
| Reihenfolge | Pro Queue | Pro Partition | Pro Stream | Nur FIFO-Queues |
| Betriebsaufwand | Mittel | Hoch | Niedrig (bei vorhandenem Redis) | Keiner (managed) |
Verwende RabbitMQ für komplexes Routing, Priority-Queues und klassische Aufgabenverteilung. Verwende Kafka für Event-Streaming mit hohem Durchsatz und Replay-Funktion. Verwende Redis Streams für leichtgewichtiges Queuing, wenn du ohnehin schon Redis im Einsatz hast. Verwende SQS, wenn du null Betriebsaufwand in AWS möchtest.
Die wichtigsten Erkenntnisse
- Nicht jeder Service-Aufruf braucht eine Queue — nutze Queues für aufschiebbare, unabhängige oder stoßweise auftretende Workloads
- At-least-once + idempotente Consumer ist der praktische Standardansatz für zuverlässiges Messaging
- RabbitMQ für Routing, Kafka für Event-Streaming mit hohem Durchsatz, Redis Streams für leichtgewichtiges Queuing
- Bestätige Nachrichten immer explizit — automatisches Acknowledgment riskiert Nachrichtenverlust bei Consumer-Abstürzen
- Partitioniere/verwende die Entity-ID als Key für Reihenfolgegarantien innerhalb der Events einer einzelnen Entität