Datenbank-Transaktionsisolationsstufen erklärt
Praktischer Überblick über Read Uncommitted, Read Committed, Repeatable Read und Serializable: verhinderte Anomalien und ihre Performance-Kosten.
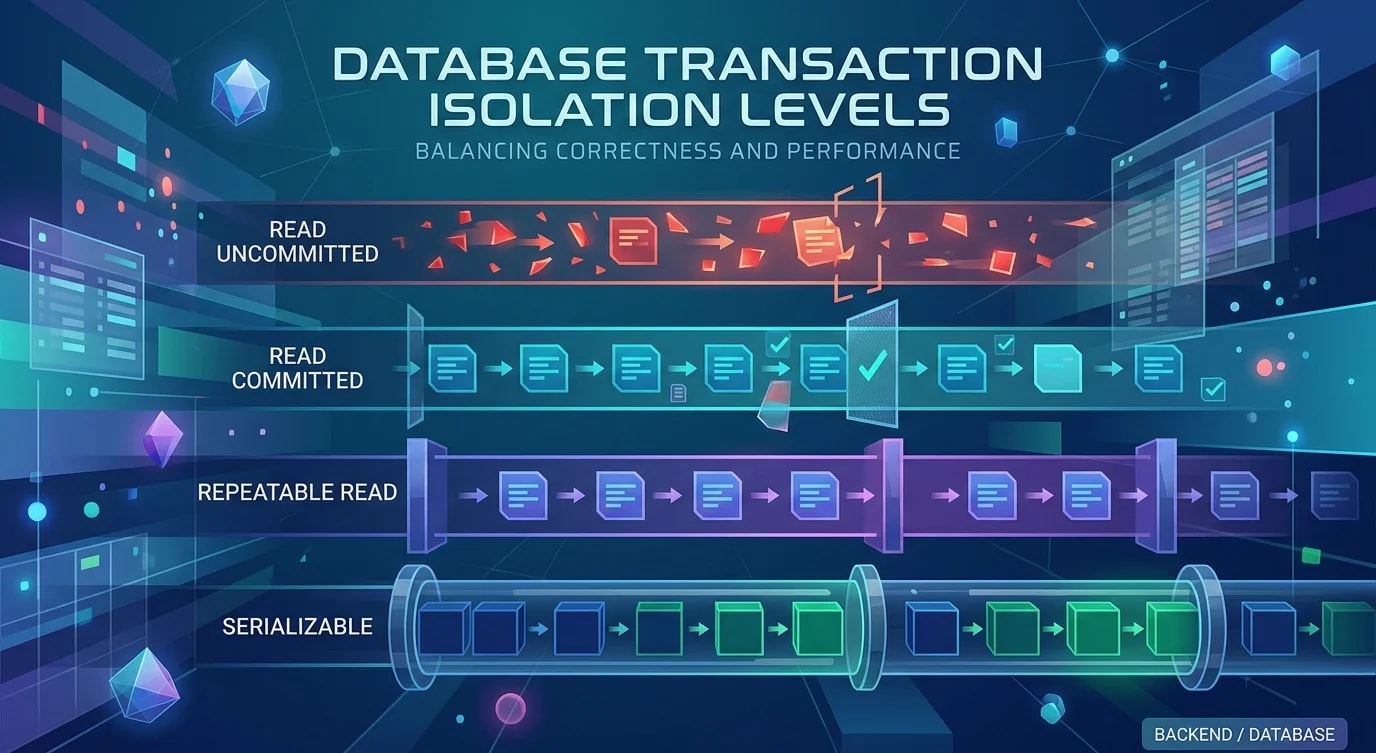
Transaktionsisolationsstufen bestimmen, welche Daten eine Transaktion sehen kann, während andere Transaktionen gleichzeitig laufen. Wählst du eine zu niedrige Stufe, liest deine Anwendung inkonsistente Daten. Wählst du eine zu hohe, serialisiert deine Datenbank alles und zerstört den Durchsatz. Die Trade-offs zu verstehen ist essenziell, um korrekte nebenläufige Systeme zu bauen.
Die meisten Entwickler verwenden einfach den Standard der Datenbank und denken nie darüber nach. Das funktioniert, bis es nicht mehr funktioniert — bis eine Report-Abfrage eine teilweise aktualisierte Bestellung liest oder zwei gleichzeitige Überweisungen ein Konto überziehen.
Die vier Isolationsstufen
SQL definiert vier Isolationsstufen, die jeweils gegen zunehmend mehr Anomalien schützen. Höhere Isolation bedeutet mehr Sicherheit, aber weniger Nebenläufigkeit.
-- PostgreSQL: Set isolation level for a transaction
BEGIN TRANSACTION ISOLATION LEVEL READ COMMITTED;
-- ... your queries ...
COMMIT;

-- Or set the default for the session
SET SESSION CHARACTERISTICS AS TRANSACTION ISOLATION LEVEL REPEATABLE READ;// TypeScript with a query builder — setting isolation per transaction
async function transferFunds(
db: Database,
fromId: string,
toId: string,
amount: number
): Promise<void> {
await db.transaction(
async (tx) => {
const from = await tx.query(
'SELECT balance FROM accounts WHERE id = $1 FOR UPDATE',
[fromId]
);
if (from.rows[0].balance < amount) {
throw new Error('Insufficient funds');
}
await tx.query(
'UPDATE accounts SET balance = balance - $1 WHERE id = $2',
[amount, fromId]
);
await tx.query(
'UPDATE accounts SET balance = balance + $1 WHERE id = $2',
[amount, toId]
);
},
{ isolationLevel: 'serializable' }
);
}Read Uncommitted: Alles sehen
Read Uncommitted erlaubt einer Transaktion, Daten zu lesen, die eine andere Transaktion geschrieben, aber noch nicht committet hat. Das ist das Problem des Dirty Read. Wird die andere Transaktion zurückgerollt, hat deine Transaktion Daten gelesen, die nie existiert haben.
-- Session A: Starts a transaction, updates a price
BEGIN;
UPDATE products SET price = 999.99 WHERE id = 42;
-- Has NOT committed yet

-- Session B (READ UNCOMMITTED): Can see the uncommitted price
SET TRANSACTION ISOLATION LEVEL READ UNCOMMITTED;
SELECT price FROM products WHERE id = 42;
-- Returns 999.99 (the UNCOMMITTED value)

-- Session A: Rolls back!
ROLLBACK;

-- Session B just used a price that never existed.
-- If this was an order calculation, the total is wrong.
In der Praxis verwendet fast niemand Read Uncommitted. PostgreSQL implementiert es nicht einmal — wenn man es setzt, bekommt man stattdessen Read Committed. Das Risiko von Dirty Reads ist für praktisch jeden Anwendungsfall zu hoch.
Read Committed: Der gängige Standard
Read Committed ist der Standard in PostgreSQL und den meisten Datenbanken. Jede Anweisung innerhalb einer Transaktion sieht nur Daten, die vor Beginn dieser Anweisung committet wurden. Keine Dirty Reads. Aber du kannst trotzdem unterschiedliche Ergebnisse sehen, wenn du dieselbe Abfrage zweimal innerhalb einer Transaktion ausführst.
-- The "non-repeatable read" problem with READ COMMITTED

-- Session A:
BEGIN;
SELECT balance FROM accounts WHERE id = 1;
-- Returns 1000

-- Session B (in between A's two queries):
UPDATE accounts SET balance = 500 WHERE id = 1;
COMMIT;

-- Session A (same transaction, second read):
SELECT balance FROM accounts WHERE id = 1;
-- Returns 500 (different from the first read!)
COMMIT;

-- Session A saw two different values for the same row
-- in the same transaction. This is a non-repeatable read.// ❌ Bug: read committed allows non-repeatable reads
async function generateReport(db: Database): Promise<Report> {
// Read committed (default)
const totalOrders = await db.query(
'SELECT SUM(amount) FROM orders WHERE status = $1',
['completed']
);
// Another transaction inserts a completed order HERE
const orderCount = await db.query(
'SELECT COUNT(*) FROM orders WHERE status = $1',
['completed']
);
// totalOrders / orderCount gives wrong average
// because the two queries saw different data
return {
total: totalOrders.rows[0].sum,
count: orderCount.rows[0].count,
average: totalOrders.rows[0].sum / orderCount.rows[0].count,
};
}
// ✅ Fix: use repeatable read for consistent snapshots
async function generateReport(db: Database): Promise<Report> {
return db.transaction(async (tx) => {
const totalOrders = await tx.query(
'SELECT SUM(amount) FROM orders WHERE status = $1',
['completed']
);
const orderCount = await tx.query(
'SELECT COUNT(*) FROM orders WHERE status = $1',
['completed']
);
// Both queries see the same snapshot — consistent results
return {
total: totalOrders.rows[0].sum,
count: orderCount.rows[0].count,
average: totalOrders.rows[0].sum / orderCount.rows[0].count,
};
}, { isolationLevel: 'repeatable read' });
}Repeatable Read: Snapshot-Konsistenz
Repeatable Read gibt jeder Transaktion einen konsistenten Snapshot der Datenbank zum Zeitpunkt des Transaktionsstarts. Keine Dirty Reads, keine Non-Repeatable Reads. Aber du kannst immer noch Phantomzeilen sehen — neue Zeilen, die von anderen Transaktionen eingefügt wurden und dein Abfrageprädikat erfüllen.
-- The "phantom read" problem (in databases that don't use MVCC)

-- Session A (REPEATABLE READ):
BEGIN;
SELECT * FROM orders WHERE total > 100;
-- Returns 5 rows

-- Session B:
INSERT INTO orders (total) VALUES (150);
COMMIT;

-- Session A:
SELECT * FROM orders WHERE total > 100;
-- In strict SQL standard: might return 6 rows (phantom row)
-- In PostgreSQL: still returns 5 rows (MVCC prevents phantoms)
COMMIT;
Die Implementierung von Repeatable Read in PostgreSQL verhindert tatsächlich auch Phantom Reads, weil sie Multi-Version Concurrency Control (MVCC) verwendet. Jede Transaktion sieht einen Snapshot vom Zeitpunkt ihres Starts, und neue Zeilen anderer Transaktionen sind unabhängig von der Abfrage unsichtbar.
-- PostgreSQL REPEATABLE READ also detects write conflicts

-- Session A:
BEGIN TRANSACTION ISOLATION LEVEL REPEATABLE READ;
UPDATE accounts SET balance = balance - 100 WHERE id = 1;

-- Session B:
BEGIN TRANSACTION ISOLATION LEVEL REPEATABLE READ;
UPDATE accounts SET balance = balance - 50 WHERE id = 1;

-- Session A commits first:
COMMIT;  -- Succeeds

-- Session B tries to commit:
COMMIT;
-- ERROR: could not serialize access due to concurrent update
-- Session B must retry the entire transaction
Serializable: Maximale Sicherheit
Serializable garantiert, dass das Ergebnis gleichzeitiger Transaktionen dasselbe ist, als hätten sie nacheinander ausgeführt. Das ist die stärkste Garantie. Sie verhindert alle Anomalien, einschließlich Write Skew und andere subtile Bugs, die Repeatable Read nicht abfängt.
// Write skew example: two doctors trying to go off-call
// At least one doctor must always be on call

// ❌ With repeatable read — write skew is possible
async function goOffCall(db: Database, doctorId: string): Promise<void> {
  await db.transaction(async (tx) => {
    const onCallCount = await tx.query(
      'SELECT COUNT(*) FROM doctors WHERE on_call = true'
    );

    if (Number(onCallCount.rows[0].count) > 1) {
      // "Safe" to go off call — at least one other doctor is on call
      await tx.query(
        'UPDATE doctors SET on_call = false WHERE id = $1',
        [doctorId]
      );
    }
    // BUT: if two doctors run this simultaneously, both see count=2,
    // both go off call, and nobody is on call!
  }, { isolationLevel: 'repeatable read' });
}

// ✅ With serializable — write skew is prevented
async function goOffCall(db: Database, doctorId: string): Promise<void> {
  await db.transaction(async (tx) => {
    const onCallCount = await tx.query(
      'SELECT COUNT(*) FROM doctors WHERE on_call = true'
    );

    if (Number(onCallCount.rows[0].count) > 1) {
      await tx.query(
        'UPDATE doctors SET on_call = false WHERE id = $1',
        [doctorId]
      );
    }
  }, { isolationLevel: 'serializable' });
  // Serializable detects the dependency between the read and write
  // One transaction succeeds, the other gets a serialization error
  // and must retry — ensuring at least one doctor stays on call
}
Die richtige Stufe wählen
Die Entscheidung hängt von deinem konkreten Anwendungsfall ab. Es gibt keine universell „richtige“ Stufe.
// Guidelines for choosing isolation level

const isolationGuide = {
  readCommitted: {
    useWhen: [
      'Most CRUD operations',
      'Writes that affect independent rows',
      'Performance is critical and slight inconsistency is acceptable',
    ],
    avoidWhen: [
      'Reports that join multiple tables',
      'Any read-then-write pattern',
    ],
  },
  repeatableRead: {
    useWhen: [
      'Reports and analytics queries',
      'Any operation that reads the same data twice',
      'Batch operations that need a consistent view',
    ],
    avoidWhen: [
      'High-contention write workloads (frequent retries)',
    ],
  },
  serializable: {
    useWhen: [
      'Financial transactions',
      'Constraint enforcement that spans multiple rows',
      'Any operation where correctness is non-negotiable',
    ],
    avoidWhen: [
      'High-throughput write workloads where retries are expensive',
      'Read-only queries (repeatable read is sufficient)',
    ],
  },
};
Wichtige Erkenntnisse
- Read Committed ist für die meisten Operationen sicher — aber jedes Read-then-Write-Muster braucht eine höhere Stufe oder explizites Locking
- Repeatable Read verhindert Non-Repeatable Reads — verwende es für Reports, Analysen und jede Leseoperation mit mehreren Abfragen
- Serializable verhindert alle Anomalien — verwende es für Finanztransaktionen und die Durchsetzung von Constraints über mehrere Zeilen
- PostgreSQLs MVCC macht Repeatable Read stärker — es verhindert auch Phantom Reads, anders als das Minimum des SQL-Standards
- Höhere Isolation bedeutet mehr Retries — Serializable-Transaktionen werden gelegentlich mit Serialisierungsfehlern fehlschlagen; dein Code muss Retries handhaben
- Standardmäßig Read Committed verwenden, gezielt eskalieren — wisse, warum du eine höhere Stufe wählst, nicht einfach nur „zur Sicherheit“


