
Engineering
Debugging von Produktionsvorfällen: Ein systematischer Ansatz
Ein bewährtes Framework zur schnellen Diagnose und Behebung von Produktionsvorfällen — vom ersten Alert bis zur Root-Cause-Analyse und Prävention.
·4 Min. Lesezeit
Tags
9 Artikel
Ein bewährtes Framework zur schnellen Diagnose und Behebung von Produktionsvorfällen — vom ersten Alert bis zur Root-Cause-Analyse und Prävention.

Structured Logging in Node.js: maschinenlesbare, durchsuchbare Einträge mit Korrelations-IDs, einheitlichen Schweregraden und Kontextweitergabe.
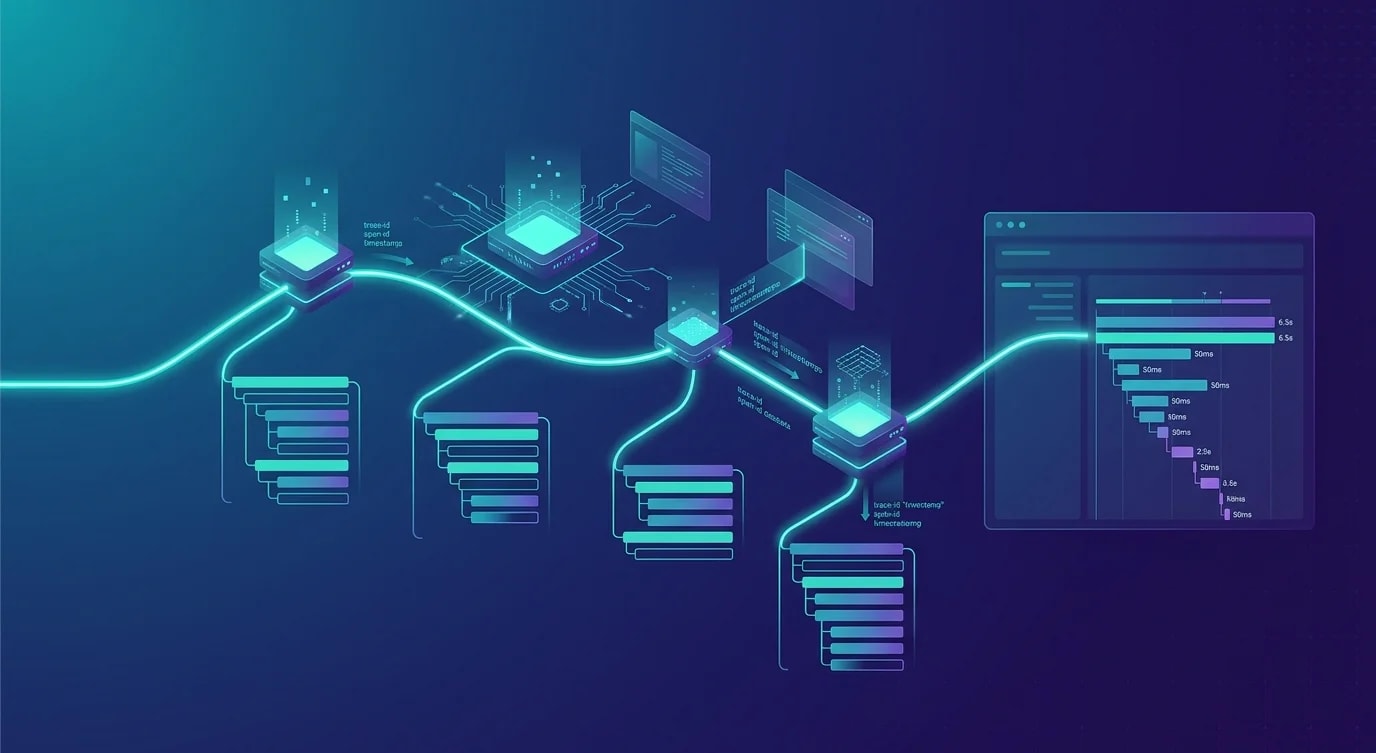
Distributed Tracing in Microservices mit OpenTelemetry: Kontextpropagation, Spans, Sampling und die Analyse, die Systeme debuggbar macht.
Debugge verteilte Systeme mit Correlation IDs, Tracing-Kontextpropagierung, Log-Aggregation und kausaler Ordnung bis zur eigentlichen Ursache.

Wie strukturiertes Logging die Fehlersuche beschleunigt: JSON-Formate, Kontextweitergabe, Log-Level, Maskierung sensibler Daten und Aggregation.

Techniken zur Diagnose von Memory Leaks, übermäßiger Allokation und OOM-Kills in Produktion — mit Heap Snapshots, Profiling-Tools und gängigen Leak-Patterns.

Wie du git bisect, bedingte Breakpoints und systematische Debugging-Techniken nutzt, um Bugs in Minuten statt Stunden zu finden.
Wenn ein Request fünf Services durchläuft, sind Logs einzeln nutzlos — Distributed Tracing verbindet sie mit Trace-IDs, Spans und Context-Propagation.

Closures, Event-Listener und nicht bereinigte Timer sind die häufigsten Memory-Leaks in Node.js — so findest du sie vor dem Produktionsausfall.