
Backend
Structured Logging für Node.js-Dienste in der Produktion
Structured Logging in Node.js: maschinenlesbare, durchsuchbare Einträge mit Korrelations-IDs, einheitlichen Schweregraden und Kontextweitergabe.
·4 Min. Lesezeit
Kategorien
APIs & Serverlogik · 57 Artikel · Seite 3 von 5
Structured Logging in Node.js: maschinenlesbare, durchsuchbare Einträge mit Korrelations-IDs, einheitlichen Schweregraden und Kontextweitergabe.

Baue Echtzeit-Datenpipelines mit Apache Kafka und TypeScript: Partitionierung, Consumer Groups, Exactly-once-Semantik und Dead Letter Queues.

Praktischer Leitfaden für durchgängige Typsicherheit in GraphQL mit Schema-first-Codegenerierung: typisierte Resolver, Query-Typen, keine Typkonflikte.
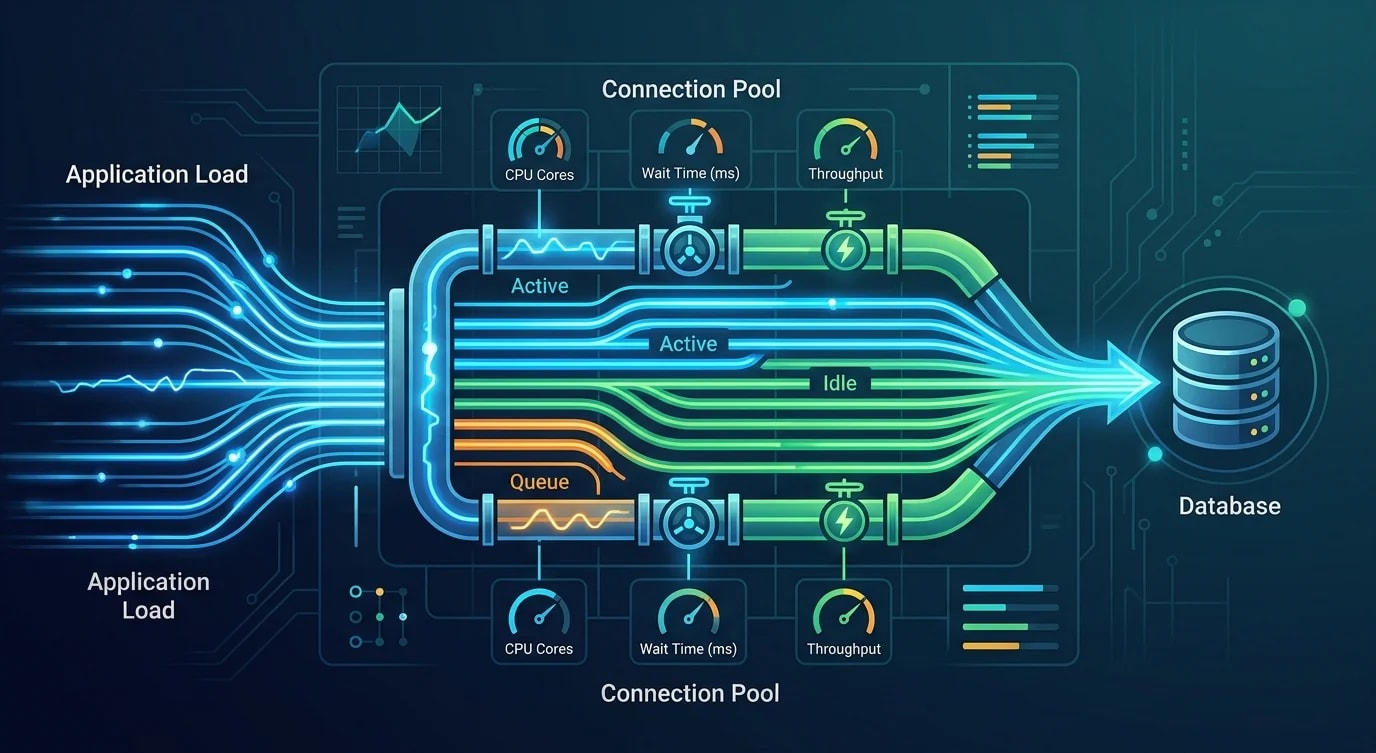
Ein tiefer Blick auf die Pool-Konfiguration: Dimensionierungsformeln, Verbindungslebenszyklus, Health Checks und Diagnose von Pool-Erschöpfung.

Detaillierter Einblick in Token Bucket, Sliding Window und Leaky Bucket, mit verteilten Redis-Implementierungen und praxisnahen Middleware-Mustern.

Praktischer Leitfaden zu GraphQL-Subscriptions für Echtzeit: WebSocket-Setup in Apollo Server, Subscription-Resolver, Client-Integration, Skalierung.

Ein tiefer Blick auf Connection-Pooling in Node.js: Pool-Dimensionierung, Health Checks, Failover-Muster und Fehlkonfigurationen mit Ausfallfolge.

Datenbankschema-Migrationen ohne Downtime: Expand-Contract-Patterns, abwärtskompatible Änderungen und stufenweise Rollouts im laufenden Betrieb.

Baue idempotente API-Endpunkte mit Idempotency-Keys, Datenbank-Constraints und Zustandsautomaten — für Zahlungen, Bestellungen und Webhooks.

Konfiguriere Datenbank-Connection-Pools für Node.js mit hohem Durchsatz: Pool-Größe, Health Checks, Lifecycle und was einen Pool erschöpft.
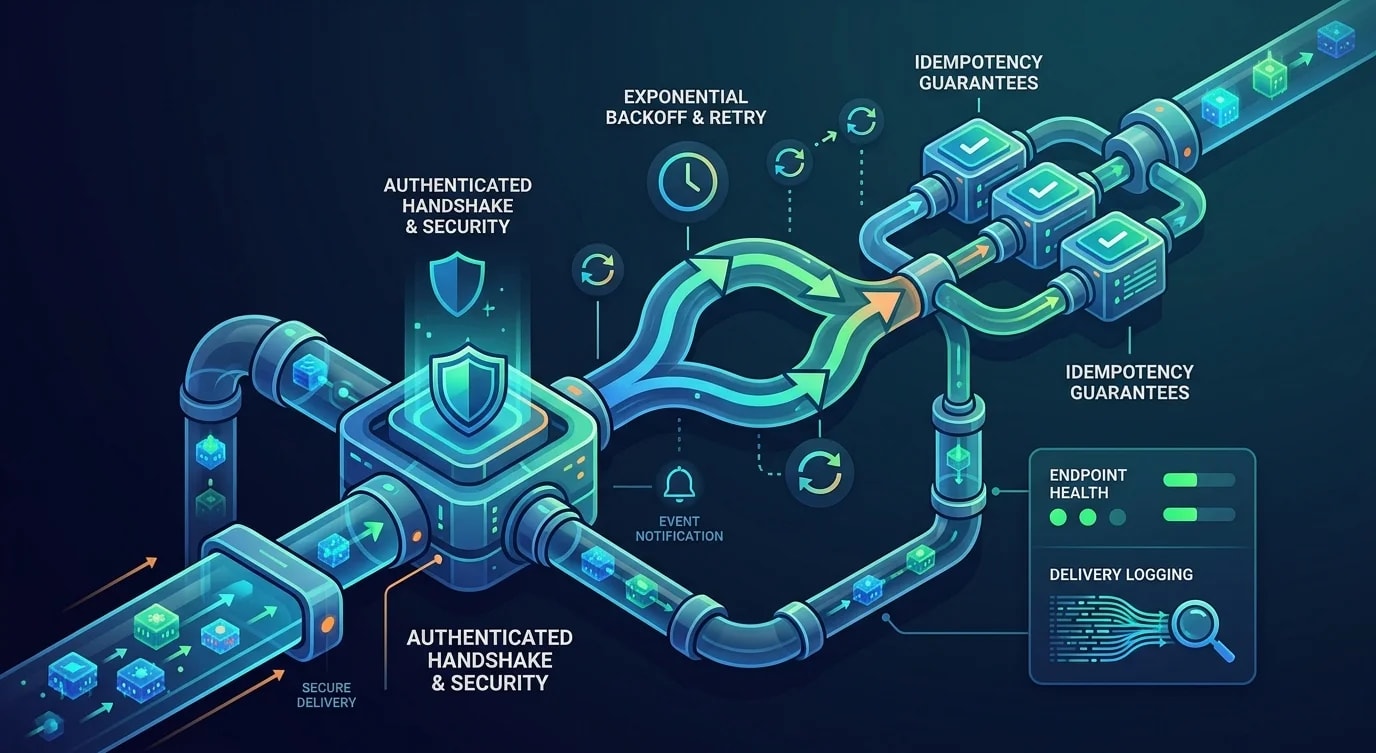
Entwirf eine Webhook-Delivery mit Retries und exponentiellem Backoff, Signaturprüfung, Idempotenz, Delivery-Logging und Endpoint-Health-Monitoring.

Baue CDC-Pipelines, die Datenbankänderungen in Echtzeit streamen: logbasierte Erfassung mit Debezium, Event-Format, Schema-Evolution, Exactly-once.