Künstliche Intelligenz
Fine-Tuning von Sprachmodellen für domänenspezifische Aufgaben
Praktischer Leitfaden zum Fine-Tuning von Sprachmodellen auf Domänendaten: Datensätze, Trainingsstrategien, Evaluation und Bereitstellung.
·5 Min. Lesezeit
Kategorien
Modelle & Integrationen · 28 Artikel · Seite 2 von 3
Praktischer Leitfaden zum Fine-Tuning von Sprachmodellen auf Domänendaten: Datensätze, Trainingsstrategien, Evaluation und Bereitstellung.

Entwirf RAG-Pipelines jenseits einfacher Demos: Chunking-Strategien, Embedding-Optimierung, Reranking und Evaluationsmetriken für die Produktion.

Praktische Techniken zur Erkennung und Minderung von Bias in ML-Pipelines — von der Datenerhebung über das Deployment bis zum Monitoring.

Grundlagen des Federated Learning, Implementierungsmuster und praktische Herausforderungen beim Training auf verteilten Geräten unter Datenschutz.

Anomalieerkennung für Anwendungsmetriken: statistische Methoden, Z-Scores, gleitende Durchschnitte, saisonale Zerlegung und Alarme ohne Alert Fatigue.
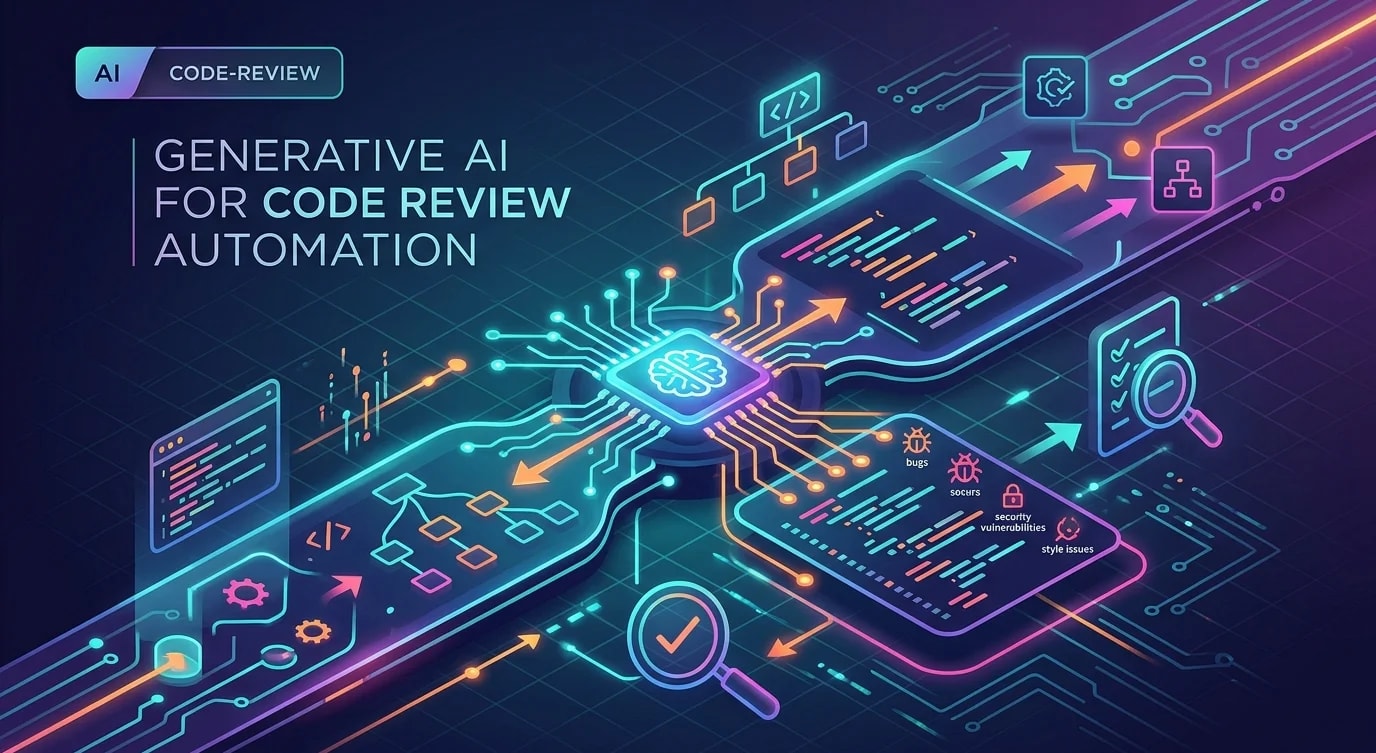
Wie man LLMs in Code-Reviews einbindet: Review-Bots, Prompt-Muster zum Bug-Finden, Sicherheitsanalysen und die Balance mit menschlichem Urteil.

Praktischer Leitfaden zu Vektordatenbanken für Ähnlichkeitssuche: Embeddings, Indexierungsstrategien, Distanzmetriken und die Wahl des Systems.

Wie man produktionsreife NLP-Pipelines baut: Textvorverarbeitung, Tokenisierung, Embeddings, Klassifikation und Entitätsextraktion.

Eine praktische Einführung in Empfehlungssysteme: Collaborative Filtering, Content-based Filtering und hybride Ansätze, in TypeScript umgesetzt.

Eine entwicklerfreundliche Einführung in die Transformer-Architektur hinter GPT, BERT und LLMs: Self-Attention, Positionscodierung, Encoder-Decoder.

Praxisnahe Einführung ins Reinforcement Learning: Agenten, Umgebungen, Belohnungen und Policies, mit TypeScript-Beispielen aus dem Alltag.

Ein anfängerfreundlicher Einstieg in Computer Vision mit Python und OpenCV: Bildverarbeitung, Kanten- und Objekterkennung und ein Bildklassifikator.